VAE 与 Diffusion Model 学习笔记
从潜变量、变分下界与重参数化出发,完整推导 DDPM 的前向边缘、条件后验、变分目标、噪声预测与采样,再连接潜空间图像、视频生成和生成后训练。
本文以 Kingma 与 Welling 的《Auto-Encoding Variational Bayes》和 Ho、Jain、Abbeel 的《Denoising Diffusion Probabilistic Models》为主线。所有数值小例子均为说明公式而构造,不是论文实验结果。
生成模型里有两句话很容易让人产生“好像懂了”的感觉:VAE 是“编码、采样、解码”,扩散模型是“加噪声再去噪”。它们都描述了操作,却没有回答更重要的问题:为什么这样训练?训练得到的网络与一个概率分布有什么关系?每个损失项从哪里来?
这篇笔记从同一个问题开始:给定一批真实数据,怎样训练一个能够生成新数据的概率模型?先用 VAE 建立潜变量、后验与变分下界的联系,再把 DDPM 看成一条结构特别清楚的潜变量链。最后讨论这条数学主线对潜空间生成、视频表示和生成后训练意味着什么。
这里刻意保留推导中经常被省略的部分:积分针对谁,期望针对谁,哪些分布是固定的,哪些参数在训练,何时可以丢掉常数,以及丢掉权重后是否还是原来的目标。
0. 先约定符号,避免把不同的“潜变量”混起来
| 符号 | 本文含义 | 是否训练 |
|---|---|---|
| \(x\in\mathbb R^D\) | VAE 的一条观测数据 | 数据本身不训练 |
| \(z\in\mathbb R^K\) | VAE 的潜变量,常取 \(K<D\) | 单次样本不是参数 |
| \(p(z)\) | VAE 潜变量先验,本文主要使用 \(\mathcal N(0,I)\) | 此处固定 |
| \(p_\theta(x\mid z)\) | VAE 的条件观测分布,由解码器输出其参数 | 训练 \(\theta\) |
| \(q_\phi(z\mid x)\) | VAE 的近似后验,由编码器输出其参数 | 训练 \(\phi\) |
| \(x_0\in\mathbb R^d\) | DDPM 的干净数据;原始图像 DDPM 在像素空间建模 | 数据本身不训练 |
| \(x_t\) | 第 \(t\) 个噪声级别的变量,与 \(x_0\) 同维 | 单次状态不是参数 |
| \(\beta_t\) | 前向第 \(t\) 步加入的噪声方差 | 原始 DDPM 中固定 |
| \(\alpha_t=1-\beta_t\) | 单步保留系数的平方 | 由 \(\beta_t\) 决定 |
| \(\bar\alpha_t=\prod_{s=1}^t\alpha_s\) | 累积保留系数的平方,约定 \(\bar\alpha_0=1\) | 由日程决定 |
| \(\widetilde\beta_t\) | 给定 \(x_t,x_0\) 后,\(x_{t-1}\) 的前向后验方差 | 可解析计算 |
| \(\sigma_t^2\) | 学到的反向转移所使用的方差;本文推导主要取固定日程 | 不等于默认的 \(\beta_t\) |
| \(\epsilon,\eta\sim\mathcal N(0,I)\) | 新抽取的标准高斯噪声 | 不训练 |
同一个字母 \(q\) 在两篇论文中扮演的角色并不完全相同。VAE 的 \(q_\phi\) 是需要学习的推断网络;原始 DDPM 的前向 \(q\) 是预先规定的加噪过程。还要区分三个“方差”:\(\beta_t\) 是前向单步方差,\(\widetilde\beta_t\) 是条件后验方差,\(\sigma_t^2\) 是反向模型的方差。把它们写成同一个符号,会让后面的推导看起来简洁,却掩盖真正的建模选择。
1. 生成模型首先是在学一个分布
假设训练数据为 \(\mathcal D=\{x^{(i)}\}_{i=1}^N\),它们来自未知分布 \(p_{\mathrm{data}}(x)\)。我们设计一个由参数 \(\theta\) 决定的模型 \(p_\theta(x)\),希望它给常见、合理的数据较高概率,并且能够从中采样。
最大似然训练写成
\[\max_\theta\ \frac1N\sum_{i=1}^N\log p_\theta(x^{(i)}).\]这里优化的是模型参数 \(\theta\),数据保持固定。把样本平均看成对真实数据分布期望的估计,就得到
\[\max_\theta\ \mathbb E_{x\sim p_{\mathrm{data}}}[\log p_\theta(x)].\]对于连续变量,\(p_\theta(x)\) 是概率密度,单点概率是零,密度值也可能大于一。本文沿用“似然”“概率模型”的常见说法,但在连续情形下,计算的实际是密度及其对数。
为什么要引入潜变量?因为复杂数据往往由许多看不见的因素共同决定。图像中可能涉及形状、位置、姿态、材质等因素。我们不必预先给每一维潜变量贴上语义标签,只需要设计一个联合分布:
\[p_\theta(x,z)=p(z)p_\theta(x\mid z).\]它对应的生成过程很简单:
- 从先验 \(p(z)\) 采样一个 \(z\);
- 从条件分布 \(p_\theta(x\mid z)\) 采样一个 \(x\)。
但是训练数据通常只给出了 \(x\),没有告诉我们它对应哪个 \(z\)。所以需要把所有可能的 \(z\) 积分掉:
\[p_\theta(x)=\int p(z)p_\theta(x\mid z)\,dz.\]这就是边缘化。模型的采样过程可以很容易,边缘似然却仍然很难计算:高维空间里有很多可能的 \(z\),神经网络解码器又让积分通常没有解析解。
另一个同样难算的量是后验:
\[p_\theta(z\mid x) =\frac{p(z)p_\theta(x\mid z)}{p_\theta(x)}.\]先验描述“还没看到数据时,潜变量可能是什么”;后验描述“看到这条数据之后,哪些潜变量更能解释它”。困难集中在分母 \(p_\theta(x)\) 上。VAE 的出发点,就是为这个难算的后验找一个可训练、可采样、可计算密度的近似分布。
2. KL 散度:比较分布时究竟平均了什么
对于两个连续分布 \(q(z)\) 和 \(p(z)\),定义
\[D_{\mathrm{KL}}(q\Vert p) =\int q(z)\log\frac{q(z)}{p(z)}\,dz =\mathbb E_{z\sim q}[\log q(z)-\log p(z)].\]这个定义里最重要的字不是“距离”,而是“在 \(q\) 下取平均”。它衡量从 \(q\) 经常采到的区域,在 \(p\) 看来是否也合理。若 \(q\) 在某处有正质量,而 \(p\) 为零,KL 可能为无穷大;下面的推导默认相关密度支持集和可积性条件满足要求。
KL 有两个常用性质:
\[D_{\mathrm{KL}}(q\Vert p)\ge 0, \qquad D_{\mathrm{KL}}(q\Vert p)=0\ \Longleftrightarrow\ q=p\text{ 几乎处处}.\]它一般不对称,\(D_{\mathrm{KL}}(q\Vert p)\) 与 \(D_{\mathrm{KL}}(p\Vert q)\) 不能互换,因此不应把它当作满足所有距离公理的普通距离。
一个后面会反复使用的事实是:若两个高斯分布具有相同固定方差,KL 关于均值差就是一个加权平方误差。例如
\[q=\mathcal N(a,s^2I),\qquad p=\mathcal N(b,s^2I)\]时,
\[D_{\mathrm{KL}}(q\Vert p)=\frac{\|a-b\|^2}{2s^2}.\]方差越小,对同样均值偏差的惩罚越大。DDPM 中出现的许多时间权重,都可以从这一点理解。
3. ELBO:用两条路推导同一个下界
3.1 从 Jensen 不等式出发
固定一条观测 \(x\),引入近似后验 \(q_\phi(z\mid x)\)。在它能覆盖被积分区域的前提下,乘除同一个密度:
\[\begin{aligned} \log p_\theta(x) &=\log\int p_\theta(x,z)\,dz\\ &=\log\int q_\phi(z\mid x) \frac{p_\theta(x,z)}{q_\phi(z\mid x)}\,dz\\ &=\log\mathbb E_{z\sim q_\phi(z\mid x)} \left[\frac{p_\theta(x,z)}{q_\phi(z\mid x)}\right]. \end{aligned}\]由于 \(\log\) 是凹函数,Jensen 不等式给出 \(\log\mathbb E[Y]\ge\mathbb E[\log Y]\)。所以
\[\log p_\theta(x) \ge \mathbb E_{q_\phi(z\mid x)} [\log p_\theta(x,z)-\log q_\phi(z\mid x)].\]右侧称为证据下界,即 Evidence Lower Bound,简称 ELBO:
\[\mathcal L(\theta,\phi;x) :=\mathbb E_{q_\phi(z\mid x)} [\log p_\theta(x,z)-\log q_\phi(z\mid x)].\]“证据”在这里指边缘似然 \(p_\theta(x)\)。把联合分布拆成 \(p(z)p_\theta(x\mid z)\):
\[\boxed{ \mathcal L(\theta,\phi;x) =\mathbb E_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)] -D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)). }\]第一项期望中的随机变量是 \(z\),\(x\) 暂时固定。第二项比较的是近似后验与先验。
3.2 从后验 KL 出发,看清“下界差多少”
只知道一个量是下界还不够。我们还想知道,它离真正的对数似然差在哪里。
从另一项 KL 开始:
\[\begin{aligned} D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p_\theta(z\mid x)) &=\mathbb E_q[\log q_\phi(z\mid x)-\log p_\theta(z\mid x)]\\ &=\mathbb E_q[\log q_\phi(z\mid x)-\log p_\theta(x,z)+\log p_\theta(x)]\\ &=-\mathcal L(\theta,\phi;x)+\log p_\theta(x). \end{aligned}\]第二行使用贝叶斯公式。第三行把 \(\log p_\theta(x)\) 提出期望,因为它不依赖于积分变量 \(z\)。于是得到精确恒等式:
\[\boxed{ \log p_\theta(x) =\mathcal L(\theta,\phi;x) +D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p_\theta(z\mid x)). }\]这两条推导解释了两个容易混淆的 KL:
- ELBO 里面的 \(D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z))\),是在比较近似后验与先验。
- 下界与真实对数似然之间的差,是 \(D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p_\theta(z\mid x))\),比较的是近似后验与真实后验。
它们的第二个分布不同,作用也不同。不能因为损失里有一个“拉向先验”的项,就说编码器应该完全忽略输入。
当 \(\theta\) 固定时,最大化 ELBO 等价于缩小近似后验与真实后验之间的 KL。当 \(\theta,\phi\) 一起更新时,模型的边缘似然和真实后验也会变化。因此“ELBO 变大”不能机械地解释成“真实似然每一步都一定变大”;它是一个有明确分解关系的可优化代理目标。
3.3 从最大化下界到最小化训练损失
实际代码通常最小化负 ELBO:
\[\mathcal J_{\mathrm{VAE}}(x) =-\mathcal L(\theta,\phi;x) =\underbrace{\mathbb E_q[-\log p_\theta(x\mid z)]}_{\text{观测的负对数似然}} +\underbrace{D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z))}_{\text{近似后验与先验的 KL}}.\]对训练集求平均,并在训练中对 \(z\) 做蒙特卡洛采样,就得到可用于优化的目标。这里还剩两个问题:如何把 KL 算出来?如何穿过随机采样对编码器求梯度?
4. VAE 的网络究竟输出什么
选择标准高斯先验:
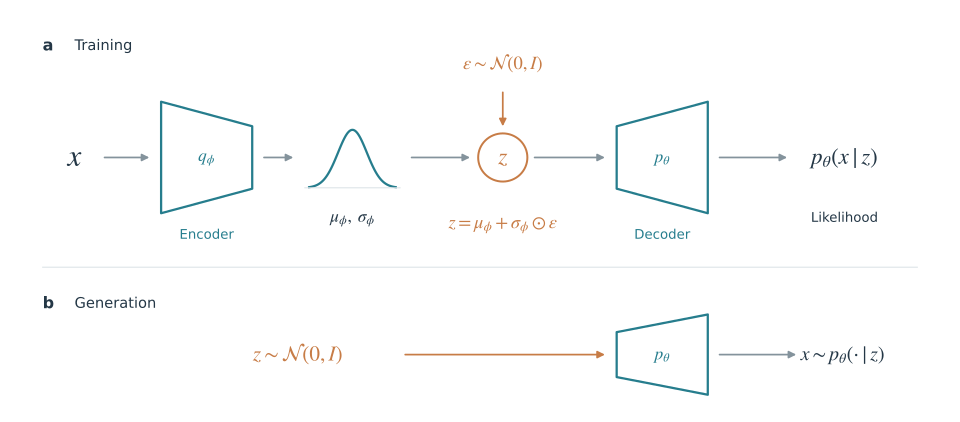
\[p(z)=\mathcal N(0,I).\]编码器输出两个 \(K\) 维向量,均值 \(\mu_\phi(x)\) 和对数方差 \(s_\phi(x)\):
\[q_\phi(z\mid x) =\mathcal N\left(\mu_\phi(x),\operatorname{diag}(\exp s_\phi(x))\right).\]这里指数逐元素计算。输出对数方差,是为了让网络可以输出任意实数,而实际方差始终为正。请特别注意:
\[s_j=\log\sigma_j^2, \qquad \sigma_j=\exp(s_j/2).\]若把标准差写成 \(\exp(s_j)\),就把方差平方了一次。这是一个看起来很小、实际会改变模型的错误。
解码器接收 \(z\),输出观测分布的参数。若使用高斯观测模型,它可能输出均值 \(f_\theta(z)\);若使用伯努利观测模型,它输出每个维度的成功概率。解码器输出一张图,并不自动意味着我们已经定义了 \(p_\theta(x\mid z)\);还需要说明围绕这张输出图采用什么概率分布。
查看原图 · 手机上可横向滑动查看完整图示。
图 1:编码器参与训练时的近似推断;生成新样本时可以直接从先验采样,再使用解码器。箭头表示计算依赖,不是实验测得的因果关系。
把 \(q_\phi\) 的参数用同一个网络从 \(x\) 预测出来,还意味着所有数据共享一套推断规则。我们不为每条数据单独维护一组独立的变分参数。这种共享推断方式称为 amortized inference,通常译作“摊销推断”。它高效,但共享网络的表达能力与优化情况也会影响近似质量。
5. 对角高斯 KL:从密度写到可执行公式
设某条固定数据的近似后验为
\[q(z)=\mathcal N(\mu,\operatorname{diag}(\sigma_1^2,\ldots,\sigma_K^2)), \quad p(z)=\mathcal N(0,I).\]对角协方差意味着给定这条观测 \(x\) 时,在这个近似后验中各维条件独立;这不保证把所有数据混合后的聚合后验也独立。它不意味着现实数据的潜在因素真的独立,也不意味着模型一定学到了可解释的解耦语义。
先写两个对数密度:
\[\log q(z) =-\frac K2\log(2\pi) -\frac12\sum_{j=1}^K\log\sigma_j^2 -\frac12\sum_{j=1}^K\frac{(z_j-\mu_j)^2}{\sigma_j^2},\] \[\log p(z) =-\frac K2\log(2\pi)-\frac12\sum_{j=1}^Kz_j^2.\]将它们相减后,对 \(z\sim q\) 取期望。利用
\[\mathbb E_q[(z_j-\mu_j)^2]=\sigma_j^2, \qquad \mathbb E_q[z_j^2]=\mu_j^2+\sigma_j^2,\]得到
\[\begin{aligned} D_{\mathrm{KL}}(q\Vert p) &=\frac12\sum_{j=1}^K \left[-\log\sigma_j^2-1+\mu_j^2+\sigma_j^2\right]\\ &=\boxed{\frac12\sum_{j=1}^K \left(\mu_j^2+\sigma_j^2-1-\log\sigma_j^2\right)}. \end{aligned}\]用编码器的对数方差输出 \(s_j\) 改写:
\[\boxed{ D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)) =\frac12\sum_j\left(\mu_j^2+e^{s_j}-1-s_j\right). }\]这部分不需要采样估计,可以直接计算并反向传播。
一个一维数值例子
取 \(q=\mathcal N(1,0.25)\)、\(p=\mathcal N(0,1)\)。则
\[D_{\mathrm{KL}}(q\Vert p) =\frac12(1+0.25-1-\log0.25) \approx0.8181.\]这里使用自然对数,单位是 nat。若 \(\mu=0,\sigma^2=1\),KL 恰好为零。若 \(\mu=0\) 而方差趋于零,\(-\log\sigma^2\) 会趋于正无穷。因此,在这个目标下,把所有后验压成确定点不是免费的。
从公式还能看出,KL 同时约束均值和方差。只把它理解成“把均值往零拉”,会遗漏一半作用。
6. 重参数化:把随机性移到不依赖参数的地方
重构项包含
\[\mathbb E_{z\sim q_\phi(z\mid x)}[f_\theta(z)], \qquad f_\theta(z)=\log p_\theta(x\mid z).\]我们既想对 \(\theta\) 求导,也想对 \(\phi\) 求导。后一个问题困难在于:\(\phi\) 不只影响函数值,还影响“从哪里采样”。普通计算图不能把一个抽象的“从参数化分布采样”操作,直接当作确定性函数随意求导。
对高斯分布,可以把同一个随机变量写成
\[\epsilon\sim\mathcal N(0,I), \qquad z=\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon.\]于是
\[\mathbb E_{z\sim q_\phi(z\mid x)}[f_\theta(z)] =\mathbb E_{\epsilon\sim\mathcal N(0,I)} [f_\theta(\mu_\phi(x)+\sigma_\phi(x)\odot\epsilon)].\]两侧分布相同;改变的是计算表达。右侧抽样的基础噪声分布不再依赖 \(\phi\),参数只出现在确定性变换中。在允许交换求导和积分的正则条件下:
\[\nabla_\phi\mathbb E_\epsilon[f_\theta(g_\phi(x,\epsilon))] =\mathbb E_\epsilon[\nabla_\phi f_\theta(g_\phi(x,\epsilon))].\]用 \(M\) 个独立噪声样本估计:
\[\nabla_\phi\mathbb E_\epsilon[f_\theta(g_\phi(x,\epsilon))] \approx\frac1M\sum_{m=1}^M \nabla_\phi f_\theta(g_\phi(x,\epsilon^{(m)})).\]这就是路径导数估计。满足条件时它是无偏的梯度估计;单个样本的损失或梯度仍然会有随机波动。
看一眼梯度为什么能通过
一维时,设 \(z=\mu+\exp(s/2)\epsilon\),则
\[\frac{\partial z}{\partial\mu}=1, \qquad \frac{\partial z}{\partial s}=\frac12\exp(s/2)\epsilon.\]链式法则继续给出
\[\frac{\partial f(z)}{\partial\mu}=f'(z), \qquad \frac{\partial f(z)}{\partial s} =f'(z)\frac12\exp(s/2)\epsilon.\]一次前向与反向计算里,抽出的 \(\epsilon\) 作为已确定的数值参与计算。我们没有“对随机数发生器求导”,而是在对把基础噪声变成潜变量的可微函数求导。
重参数化并不是对随机期望求梯度的唯一方法。若函数 \(f\) 本身不显式依赖 \(\phi\),在支持集不随参数变化且可交换微分与积分等条件下,还可写出
\[\begin{aligned} \nabla_\phi\mathbb E_{q_\phi}[f(z)] &=\int f(z)\nabla_\phi q_\phi(z)\,dz\\ &=\mathbb E_{q_\phi}[f(z)\nabla_\phi\log q_\phi(z)]. \end{aligned}\]这叫 score-function 或 likelihood-ratio 估计。它不需要把样本表示成可微变换,但估计方差可能较大。若 \(f\) 还显式依赖 \(\phi\),需另外加上 \(\mathbb E_q[\nabla_\phi f]\)。因此更准确的说法是:重参数化提供了一条方便且常常有效的梯度路径,而不是“随机变量原则上不能求导”。
重构损失为什么有时是 MSE,有时是交叉熵
如果定义
\[p_\theta(x\mid z)=\mathcal N(f_\theta(z),\tau^2 I),\]且 \(\tau^2\) 为固定常数,那么
\[-\log p_\theta(x\mid z) =\frac{1}{2\tau^2}\|x-f_\theta(z)\|^2 +\frac D2\log(2\pi\tau^2).\]最后一项不依赖训练参数,可以在优化时省略。平方误差因此来自一个明确的高斯观测假设,而不是“VAE 天生就应该用 MSE”。若同时学习观测方差,对数方差项就不能再扔掉。
若 \(x_j\in\{0,1\}\),并采用条件独立的伯努利观测模型
\[p_\theta(x\mid z)=\prod_j\pi_{\theta,j}(z)^{x_j} (1-\pi_{\theta,j}(z))^{1-x_j},\]则负对数似然为
\[-\log p_\theta(x\mid z) =-\sum_j\left[x_j\log\pi_{\theta,j}(z) +(1-x_j)\log(1-\pi_{\theta,j}(z))\right].\]这正是二元交叉熵。对一般连续像素,直接使用这个表达式可能是一种工程损失选择,但不应不加说明地称作连续数据的伯努利似然。
一条数据的完整 VAE 训练步骤
- 把 \(x\) 输入编码器,得到 \(\mu_\phi(x)\) 和 \(s_\phi(x)\)。
- 抽取 \(\epsilon\sim\mathcal N(0,I)\),计算 \(z=\mu+\exp(s/2)\odot\epsilon\)。
- 将 \(z\) 输入解码器,得到观测分布参数。
- 计算 \(-\log p_\theta(x\mid z)\),加上解析高斯 KL。
- 对一个 minibatch 求平均,更新 \(\theta\) 与 \(\phi\)。
生成时则只需要从 \(p(z)\) 抽样,再通过 \(p_\theta(x\mid z)\) 生成数据。取解码器均值是常见的确定性输出方式;它与从完整观测分布采样,是两个不同操作。
两个经常被忽略的缩放问题
第一,像素重构项按维度求和、KL 按潜维度求和,对 batch 再取平均,是一种清楚的概率记账方式。如果一边对像素取平均,一边对潜维度求和,却不调整系数,就改变了两项的相对权重。
第二,若写成
\[\mathcal J=\mathbb E_q[-\log p_\theta(x\mid z)] +\lambda D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)),\]当 \(\lambda\ne1\) 时,通常已不是刚才那个生成模型的原始负 ELBO。它可能是有用的变体,但应该把“推导得出的目标”和“为某种效果修改的目标”分开陈述。
用一个完整的一维模型核对 ELBO
前面的高斯 KL 例子只核对了一个损失项。现在选一个所有量都能手算的模型,把证据、近似后验和下界放在一起:
\[p(z)=\mathcal N(0,1),\qquad p(x\mid z)=\mathcal N(z,1),\qquad x=1.\]这相当于 \(x=z+\eta\),其中 \(z,\eta\) 是独立标准高斯,所以边缘分布为 \(p(x)=\mathcal N(0,2)\)。由此
\[\log p(1)=-\frac12\log(4\pi)-\frac14\approx-1.515512.\]真实后验也能通过配方求出:
\[p(z\mid1)\propto\exp\left[-\frac12z^2-\frac12(1-z)^2\right].\]因为
\[z^2+(1-z)^2=2\left(z-\frac12\right)^2+\frac12,\]所以
\[p(z\mid1)=\mathcal N\left(\frac12,\frac12\right).\]第二个参数表示方差。现在故意选一个不完全准确的近似后验:
\[q(z\mid1)=\mathcal N\left(\frac12,\frac14\right).\]它的均值正确,方差偏小。重构项中的平方误差期望为
\[\mathbb E_q[(1-z)^2] =(1-\mathbb E_qz)^2+\operatorname{Var}_q(z) =\frac14+\frac14=\frac12.\]于是
\[\mathbb E_q[\log p(1\mid z)] =-\frac12\log(2\pi)-\frac12\times\frac12 \approx-1.168939.\]先验 KL 为
\[D_{\mathrm{KL}}(q(z\mid1)\Vert p(z)) =\frac12\left[\frac14+\frac14-1-\log\frac14\right] \approx0.443147.\]所以
\[\mathcal L\approx-1.168939-0.443147=-1.612086.\]再直接计算近似后验与真实后验之间的 KL:
\[D_{\mathrm{KL}}\left(\mathcal N(1/2,1/4)\Vert\mathcal N(1/2,1/2)\right) =\frac12\left[\frac{1/4}{1/2}-1+\log\frac{1/2}{1/4}\right] \approx0.096574.\]三者恰好满足
\[\underbrace{-1.515512}_{\log p(1)} =\underbrace{-1.612086}_{\mathrm{ELBO}} +\underbrace{0.096574}_{\text{后验近似差距}}.\]这个例子还有一个容易漏掉的提醒:ELBO 的下界性质针对完整期望,不保证每一次蒙特卡洛估计都低于对数似然。假设一次采样在 \(z=0.5\) 附近,并用解析先验 KL,那么单样本估计在该点的数值是
\[\widehat{\mathcal L} =\log p(1\mid z=0.5)-0.443147 \approx-1.487086,\]它高于 \(\log p(1)\approx-1.515512\)。精确抽中一个连续点的概率为零,但该点附近同样存在超过证据的样本估计;这不违反下界,因为期望后的 \(\mathcal L\) 才是下界。训练日志中的随机 minibatch 估计有波动,不能逐个数值都当作严格证据界来解释。
7. 从一个潜变量,走到一整条潜变量链
VAE 引入一个潜变量 \(z\)。DDPM 则引入一串与数据同维的变量 \(x_1,\ldots,x_T\)。直觉是:直接从简单噪声生成复杂数据很困难,可以把任务拆成很多个小的反向步骤。
但必须先说明正向过程。对一条干净数据 \(x_0\),定义
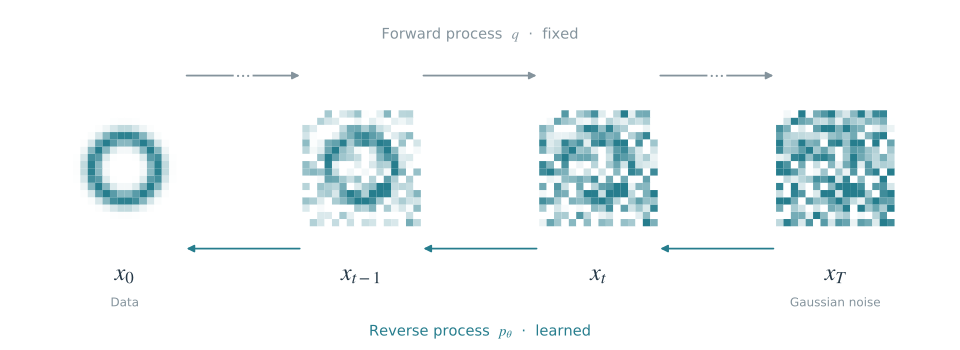
\[q(x_{1:T}\mid x_0)=\prod_{t=1}^Tq(x_t\mid x_{t-1}),\] \[\boxed{ q(x_t\mid x_{t-1}) =\mathcal N(\sqrt{\alpha_t}x_{t-1},\beta_tI), \qquad\alpha_t=1-\beta_t. }\]这里假设每一步 \(0<\beta_t<1\),因此 \(0<\alpha_t<1\)。等价的采样写法是
\[x_t=\sqrt{\alpha_t}x_{t-1}+\sqrt{\beta_t}\epsilon_t, \qquad \epsilon_t\sim\mathcal N(0,I).\]每一步不仅加入噪声,也把原信号乘上小于一的系数。正是这种成对设计,使得标准高斯具有方便的稳定性:如果 \(x_{t-1}\sim\mathcal N(0,I)\) 且与新噪声独立,新的方差是 \(\alpha_tI+\beta_tI=I\)。
原始 DDPM 固定这个前向过程,训练的是反向生成过程:
\[p_\theta(x_{0:T})=p(x_T)\prod_{t=1}^Tp_\theta(x_{t-1}\mid x_t), \qquad p(x_T)=\mathcal N(0,I).\]对中间连续状态,通常使用高斯反向转移:
\[p_\theta(x_{t-1}\mid x_t) =\mathcal N(\mu_\theta(x_t,t),\sigma_t^2I).\]生成顺序为 \(x_T\to x_{T-1}\to\cdots\to x_0\)。最后一步如何解释为像素观测分布,需要额外说明,后文会单独讨论。
查看原图 · 手机上可横向滑动查看完整图示。
图 2:前向加噪日程固定,反向网络通过带时间条件的局部转移生成样本。示意色块只说明信号逐渐被噪声淹没,不代表任何模型的真实生成结果。
这里有一个重要区别:给定 \(x_{t-1}\) 的前向转移是高斯,并不自动意味着真实数据分布下的精确反向条件 \(q(x_{t-1}\mid x_t)\) 也一定是高斯。DDPM 选择用高斯反向转移建模;当步骤足够细时,这种局部建模有相应动机。后面能精确写成高斯的是额外给定干净样本 \(x_0\) 的 \(q(x_{t-1}\mid x_t,x_0)\)。
8. 第一个关键公式:任意时间的带噪样本可以一步得到
训练不必每次真的从 \(x_0\) 连续加噪 \(t\) 次。我们可以直接采样 \(x_t\mid x_0\)。
8.1 先展开前两步
第一步:
\[x_1=\sqrt{\alpha_1}x_0+\sqrt{\beta_1}\epsilon_1.\]第二步:
\[\begin{aligned} x_2 &=\sqrt{\alpha_2}x_1+\sqrt{\beta_2}\epsilon_2\\ &=\sqrt{\alpha_2\alpha_1}x_0 +\sqrt{\alpha_2\beta_1}\epsilon_1 +\sqrt{\beta_2}\epsilon_2. \end{aligned}\]由于两份噪声独立,它们线性组合的方差为
\[\alpha_2\beta_1+\beta_2 =\alpha_2(1-\alpha_1)+(1-\alpha_2) =1-\alpha_1\alpha_2.\]于是 \(x_2\mid x_0\) 是均值为 \(\sqrt{\alpha_1\alpha_2}x_0\)、协方差为 \((1-\alpha_1\alpha_2)I\) 的高斯分布。
8.2 用递推推广到第 t 步
假设
\[x_{t-1}\mid x_0\sim \mathcal N(\sqrt{\bar\alpha_{t-1}}x_0,(1-\bar\alpha_{t-1})I).\]代入单步转移,条件均值变成
\[\sqrt{\alpha_t}\sqrt{\bar\alpha_{t-1}}x_0 =\sqrt{\bar\alpha_t}x_0,\]条件方差变成
\[\alpha_t(1-\bar\alpha_{t-1})+\beta_t =1-\alpha_t\bar\alpha_{t-1} =1-\bar\alpha_t.\]因此得到
\[\boxed{ q(x_t\mid x_0) =\mathcal N(\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I). }\]直接采样形式为
\[\boxed{ x_t=\sqrt{\bar\alpha_t}x_0 +\sqrt{1-\bar\alpha_t}\epsilon, \qquad\epsilon\sim\mathcal N(0,I). }\]这里的 \(\epsilon\) 是这一时间点的“总噪声”表示。它与某一次原始单步噪声 \(\epsilon_t\) 不应混为一谈。这个公式保证单个时间边缘分布正确;如果为了画一条真实前向轨迹,分别对每个 \(t\) 独立抽总噪声,那些点一般不具有原先马尔可夫链的联合分布。
8.3 终点为什么接近标准高斯
当日程使 \(\bar\alpha_T\) 很小时,给定 \(x_0\) 的均值 \(\sqrt{\bar\alpha_T}x_0\) 很小,方差 \((1-\bar\alpha_T)I\) 接近 \(I\)。于是终点与标准高斯接近。
这里“接近”依赖日程、数据尺度及有关分布条件;有限步数并不保证严格相等。不能在证明里直接把 \(q(x_T\mid x_0)\) 当作精确的 \(\mathcal N(0,I)\),然后宣布终点 KL 一定为零。
一个常用的相对尺度是
\[\mathrm{SNR}(t)=\frac{\bar\alpha_t}{1-\bar\alpha_t}.\]当数据各维已大致标准化时,它可解释为信号与噪声的功率比。数据本身的方差若不是一,还需要计入实际信号尺度。不同时间的任务之所以不同,很大程度上来自这个比例的变化。
9. 第二个关键公式:给定干净样本,反向一步的后验是高斯
我们想计算
\[q(x_{t-1}\mid x_t,x_0),\qquad t\ge2.\]它比生成时真正需要的 \(q(x_{t-1}\mid x_t)\) 多知道了 \(x_0\)。训练数据恰好提供 \(x_0\),所以它可以作为训练时的解析参照。
为了避免符号淹没推导,暂时记
\[y=x_{t-1},\quad a=\alpha_t,\quad b=\beta_t,\quad c=\bar\alpha_{t-1}.\]于是 \(\bar\alpha_t=ac\),并且
\[q(x_t\mid y)=\mathcal N(\sqrt a\,y,bI), \qquad q(y\mid x_0)=\mathcal N(\sqrt c\,x_0,(1-c)I).\]9.1 用贝叶斯公式相乘
给定 \(x_t,x_0\) 后,忽略不依赖 \(y\) 的归一化因子:
\[q(y\mid x_t,x_0)\propto q(x_t\mid y)q(y\mid x_0).\]取对数,把所有与 \(y\) 无关的项统称为 \(C\):
\[\log q(y\mid x_t,x_0) =-\frac{1}{2b}\|x_t-\sqrt a\,y\|^2 -\frac{1}{2(1-c)}\|y-\sqrt c\,x_0\|^2+C.\]展开平方:
\[=-\frac12\left[ \left(\frac ab+\frac1{1-c}\right)\|y\|^2 -2\left(\frac{\sqrt a}{b}x_t+ \frac{\sqrt c}{1-c}x_0\right)^\top y \right]+C'.\]9.2 识别精度,再完成平方
定义标量精度与线性系数
\[A=\frac ab+\frac1{1-c}, \qquad h=\frac{\sqrt a}{b}x_t+\frac{\sqrt c}{1-c}x_0.\]因为 \(a+b=1\),
\[A=\frac{a(1-c)+b}{b(1-c)} =\frac{1-ac}{b(1-c)}.\]完成平方:
\[A\|y\|^2-2h^\top y =A\|y-A^{-1}h\|^2-A^{-1}\|h\|^2.\]最后一项不依赖 \(y\),可合并进归一化常数。所以这个密度是高斯,方差为 \(A^{-1}\),均值为 \(A^{-1}h\)。
还原符号,得到
\[\boxed{ \widetilde\beta_t =\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t, }\] \[\boxed{ \widetilde\mu_t(x_t,x_0) =\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x_0 +\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x_t. }\]也就是说
\[q(x_{t-1}\mid x_t,x_0) =\mathcal N(\widetilde\mu_t(x_t,x_0),\widetilde\beta_tI).\]推导中被省略的常数只是不依赖待积分变量 \(y\),它们仍然可能依赖 \(x_t,x_0\) 和日程。这里的目标是识别关于 \(y\) 的条件分布,所以允许这样处理;不能把这种“常数”不加区分地用于另一项参数优化。
9.3 一个可手算的例子
取一维 \(x_0=2\),\(\beta_1=0.1,\beta_2=0.2\),于是
\[\alpha_1=0.9,\quad\alpha_2=0.8, \quad\bar\alpha_1=0.9,\quad\bar\alpha_2=0.72.\]所以
\[q(x_2\mid x_0=2)=\mathcal N(2\sqrt{0.72},0.28) \approx\mathcal N(1.6971,0.28).\]若这一次总噪声恰好为 \(\epsilon=0.5\),那么
\[x_2=2\sqrt{0.72}+\sqrt{0.28}\times0.5\approx1.9616.\]此时
\[\widetilde\beta_2=\frac{0.1}{0.28}\times0.2\approx0.07143,\] \[\widetilde\mu_2 =\frac{\sqrt{0.9}\times0.2}{0.28}\times2 +\frac{\sqrt{0.8}\times0.1}{0.28}\times1.9616 \approx1.9819.\]于是给定这组 \(x_0,x_2\),中间状态 \(x_1\) 的条件分布为约 \(\mathcal N(1.9819,0.07143)\)。这里的噪声日程专为手算选择,不是训练建议。
9.4 为什么公式只直接用于 t ≥ 2
当 \(t=1\),约定 \(\bar\alpha_0=1\),于是 \(\widetilde\beta_1=0\)。这反映了一个事实:当我们已经给定 \(x_0\),再去问“\(x_0\) 的条件分布”就是集中在已知值的退化分布。
这时不能把方差为零的对象当作普通非退化高斯,硬塞进包含除法和对数的 KL 公式。DDPM 变分分解中的第一步因此单独表现为观测负对数似然项。
9.5 去掉干净样本这个条件,为什么就没那么简单了
对 \(t\ge2\),精确反向条件可以写成
\[q(x_{t-1}\mid x_t) =\int q(x_{t-1}\mid x_t,x_0)q(x_0\mid x_t)\,dx_0.\]这里以及后续对 \(x_0\) 的边缘化采用连续积分记法;若 \(x_0\) 为离散像素变量,相应积分应改成求和。第一个因子已经是已知形式的高斯,第二个因子却描述“给定这份带噪数据,哪些干净数据是可能的”。它与真实数据分布有关,一般很复杂。因此,右边是许多不同均值高斯的混合,通常不再是单个高斯。
条件方差公式进一步揭示这种不确定性:
\[\operatorname{Cov}(x_{t-1}\mid x_t) =\widetilde\beta_tI +\operatorname{Cov}_{x_0\mid x_t} \left(\widetilde\mu_t(x_t,x_0)\right).\]第一项是即使知道 \(x_0\) 仍有的后验噪声;第二项是“不知道干净数据到底是什么”额外带来的均值不确定性。网络学习反向分布时,面对的是后者也存在的情形。这解释了为什么“训练时解析可得的后验”不能直接拿来当生成算法:生成时并没有真实 \(x_0\) 可代入。
10. 第三个关键公式:DDPM 的完整变分目标怎样拆开
现在已经有固定前向链 \(q(x_{1:T}\mid x_0)\) 和可训练反向链 \(p_\theta(x_{0:T})\)。对固定的观测 \(x_0\),与 VAE 相同的 Jensen 推导给出
\[\log p_\theta(x_0) \ge\mathbb E_{q(x_{1:T}\mid x_0)} \left[\log\frac{p_\theta(x_{0:T})}{q(x_{1:T}\mid x_0)}\right].\]定义负下界
\[L_{\mathrm{VLB}}(x_0) :=\mathbb E_q\left[ -\log p(x_T) -\sum_{t=1}^T\log p_\theta(x_{t-1}\mid x_t) +\sum_{t=1}^T\log q(x_t\mid x_{t-1}) \right].\]于是
\[-\log p_\theta(x_0)\le L_{\mathrm{VLB}}(x_0).\]“负下界”是对负对数似然的上界。讨论损失方向时,这个负号很容易让人混淆。
10.1 为什么能出现刚才推出来的后验
对 \(t\ge2\),贝叶斯公式给出
\[q(x_t\mid x_{t-1}) =q(x_{t-1}\mid x_t,x_0) \frac{q(x_t\mid x_0)}{q(x_{t-1}\mid x_0)}.\]这里利用前向马尔可夫性质:给定 \(x_{t-1}\),下一步 \(x_t\) 不再额外依赖 \(x_0\)。把所有项相乘:
\[\begin{aligned} q(x_{1:T}\mid x_0) &=q(x_1\mid x_0)\prod_{t=2}^Tq(x_t\mid x_{t-1})\\ &=q(x_1\mid x_0)\prod_{t=2}^T \left[q(x_{t-1}\mid x_t,x_0) \frac{q(x_t\mid x_0)}{q(x_{t-1}\mid x_0)}\right]. \end{aligned}\]比值里的项逐个抵消:分母的 \(q(x_1\mid x_0)\) 与最前面的因子抵消,中间每个边缘密度也互相抵消,只留下 \(q(x_T\mid x_0)\)。因此
\[\boxed{ q(x_{1:T}\mid x_0) =q(x_T\mid x_0)\prod_{t=2}^Tq(x_{t-1}\mid x_t,x_0). }\]这个恒等式把同一条前向联合分布,重写成“给定起点的反向分解”。它没有把 \(q\) 换成模型 \(p_\theta\),也没有训练新的网络。
10.2 放回负下界,并按条件期望分组
用上述分解代入:
\[\begin{aligned} L_{\mathrm{VLB}}(x_0) =\mathbb E_q\Bigg[ &\log\frac{q(x_T\mid x_0)}{p(x_T)}\\ &+\sum_{t=2}^T\log\frac{q(x_{t-1}\mid x_t,x_0)} {p_\theta(x_{t-1}\mid x_t)}\\ &-\log p_\theta(x_0\mid x_1) \Bigg]. \end{aligned}\]第一项只涉及 \(x_T\);中间项先固定 \(x_t,x_0\),对 \(x_{t-1}\) 的条件后验取期望;最后一项只需要 \(x_1\) 的边缘分布。最终得到
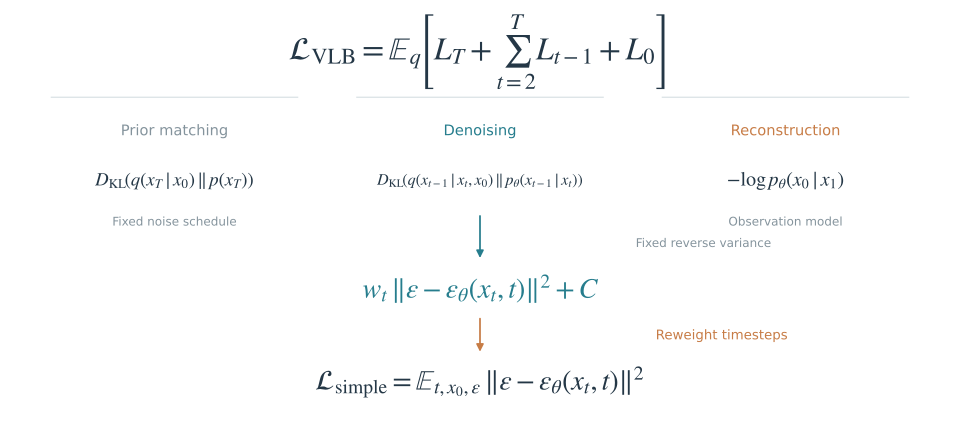
\[\boxed{ L_{\mathrm{VLB}}(x_0) =L_T(x_0)+\sum_{t=2}^TL_{t-1}(x_0)+L_0(x_0), }\]其中
\[L_T(x_0) =D_{\mathrm{KL}}(q(x_T\mid x_0)\Vert p(x_T)),\] \[L_{t-1}(x_0) =\mathbb E_{x_t\sim q(x_t\mid x_0)} \left[D_{\mathrm{KL}}\big(q(x_{t-1}\mid x_t,x_0) \Vert p_\theta(x_{t-1}\mid x_t)\big)\right],\] \[L_0(x_0) =\mathbb E_{x_1\sim q(x_1\mid x_0)}[-\log p_\theta(x_0\mid x_1)].\]对 \(x_0\sim p_{\mathrm{data}}\) 再取期望,才得到整个数据分布上的训练目标。论文中有时把外层期望放在总式外面,记号略有不同,但涉及的随机变量相同。
查看原图 · 手机上可横向滑动查看完整图示。
图 3:负 ELBO 的三个部分。中间每个高斯 KL 进一步化为均值回归;只有在固定方差等条件下,才可继续化为带明确时间权重的噪声回归。
10.3 三个部分各自负责什么
终点项 \(L_T\): 前向终点是否与采样先验匹配。令 \(d\) 为数据维度,可以直接算出
\[L_T(x_0) =\frac12\left[ \bar\alpha_T\|x_0\|^2 -d\bar\alpha_T-d\log(1-\bar\alpha_T) \right].\]如果日程与先验固定,它不依赖 \(\theta\),所以训练反向网络时可以不计算它的梯度。它仍然属于完整似然界;“不影响这组参数的梯度”与“数值等于零”是不同的判断。
中间项 \(L_{t-1}\): 让反向模型接近已知干净样本时的真实前向后验。训练时我们知道 \(x_0\),但模型输入通常只有 \(x_t,t\);这形成了监督信号与网络可用信息之间的区分。
观测项 \(L_0\): 从接近数据的 \(x_1\),给真实观测 \(x_0\) 分配概率。它属于观测模型,而不是直接延续一个方差为零的高斯 KL。
原始 DDPM 处理离散的图像像素时,使用高斯在量化区间上的积分作为观测概率。若像素已线性缩放到 \([-1,1]\),相邻 8-bit 像素中心间距是 \(2/255\);内部像素对应半宽 \(1/255\) 的区间,两端区间延伸到无穷。
设某一维像素对应区间 \([a_i,b_i]\),则
\[p_\theta(x_0^i\mid x_1) =\Phi\left(\frac{b_i-\mu_\theta^i(x_1,1)}{\sigma_1}\right) -\Phi\left(\frac{a_i-\mu_\theta^i(x_1,1)}{\sigma_1}\right),\]其中 \(\Phi\) 为标准正态分布的累积分布函数,观测分布使用正的尺度参数。这个表达式把连续高斯密度转成真正的离散概率,细节见 DDPM 原论文 §3.3。若教程只写“所有时间步都是 MSE”,就遗漏了完整概率模型的这个边界。原论文
在上述离散观测模型下,若完整负 ELBO 使用自然对数,除以 \(d\log2\) 后就是每维比特数(bits/dim)意义下的负对数似然上界。后面将出现的简化 MSE 不能直接当作这个似然指标。若换成连续去量化或不同像素缩放的密度模型,还需要单独跟踪去量化和尺度变换,不能只拿两个损失数值横向比较。
11. 从均值预测走到噪声预测:每个系数都从哪里来
11.1 两个不同方差的各向同性高斯之间的 KL
固定 \(x_t,x_0\),设
\[q=\mathcal N(\widetilde\mu_t,\widetilde\beta_tI), \qquad p_\theta=\mathcal N(\mu_\theta,\sigma_t^2I).\]高斯 KL 为
\[\begin{aligned} D_{\mathrm{KL}}(q\Vert p_\theta) =&\ \frac{1}{2\sigma_t^2}\|\widetilde\mu_t-\mu_\theta\|^2\\ &+\frac d2\left[ \frac{\widetilde\beta_t}{\sigma_t^2}-1 +\log\frac{\sigma_t^2}{\widetilde\beta_t} \right]. \end{aligned}\]如果 \(\sigma_t^2\) 预先固定,第二行与模型的均值参数无关。优化均值时可简化为加权均值平方误差。如果方差也由网络学习,那么第二行和第一行的分母都与训练参数有关,不能照搬“加一个常数”的说法。
原论文讨论固定 \(\sigma_t^2=\beta_t\) 或 \(\sigma_t^2=\widetilde\beta_t\) 的选择;上述中间 KL 的推导限于 \(t\ge2\),最终观测步仍需单独处理。DDPM §3.2–3.3
11.2 把后验均值中的 干净样本 换成噪声
由直接加噪公式
\[x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon,\]解出
\[x_0=\frac{x_t-\sqrt{1-\bar\alpha_t}\epsilon}{\sqrt{\bar\alpha_t}}.\]把它代入第 9 节的 \(\widetilde\mu_t\):
\[\begin{aligned} \widetilde\mu_t =&\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t} \frac{x_t-\sqrt{1-\bar\alpha_t}\epsilon}{\sqrt{\bar\alpha_t}}\\ &+\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x_t. \end{aligned}\]由于 \(\bar\alpha_t=\alpha_t\bar\alpha_{t-1}\),第一行对 \(x_t\) 的系数为 \(\beta_t/[\sqrt{\alpha_t}(1-\bar\alpha_t)]\)。两项系数相加:
\[\begin{aligned} &\frac{\beta_t+\alpha_t(1-\bar\alpha_{t-1})} {\sqrt{\alpha_t}(1-\bar\alpha_t)}\\ &\qquad=\frac{1-\bar\alpha_t} {\sqrt{\alpha_t}(1-\bar\alpha_t)} =\frac1{\sqrt{\alpha_t}}. \end{aligned}\]噪声项系数则为 \(-\beta_t/[\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}]\)。因此
\[\boxed{ \widetilde\mu_t(x_t,x_0) =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon\right). }\]于是选择让网络预测噪声,定义反向均值
\[\boxed{ \mu_\theta(x_t,t) =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}} \epsilon_\theta(x_t,t)\right). }\]这是参数化选择:网络输出 \(\epsilon_\theta\),通过确定性公式转成高斯均值。网络并不是另一个单独训练的“噪声生成器”。
11.3 精确写出噪声 MSE 的时间权重
两者相减:
\[\widetilde\mu_t-\mu_\theta =\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}} \left(\epsilon_\theta(x_t,t)-\epsilon\right).\]代入均值 KL,得到对 \(t\ge2\):
\[L_{t-1}(x_0) =\mathbb E_{\epsilon\sim\mathcal N(0,I)} \left[w_t\|\epsilon-\epsilon_\theta(x_t,t)\|^2\right]+C_t,\] \[\boxed{ w_t=\frac{\beta_t^2}{2\sigma_t^2\alpha_t(1-\bar\alpha_t)}. }\]其中 \(x_t\) 通过 \(x_0,\epsilon\) 构造;若反向方差固定,\(C_t\) 与均值网络参数无关。两种固定方差对应:
\[\sigma_t^2=\beta_t \quad\Longrightarrow\quad w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_t)},\] \[\sigma_t^2=\widetilde\beta_t \quad\Longrightarrow\quad w_t=\frac{\beta_t}{2\alpha_t(1-\bar\alpha_{t-1})},\qquad t\ge2.\]同样的噪声预测误差,在不同时间步对完整变分目标的贡献不同。这个权重来自高斯概率模型,不是随手添加的训练技巧。
11.4 为什么随机抽一个时间步就够训练
若某个中间目标是 \(\sum_{t=2}^T\ell_t\),均匀抽取 \(t\in\{2,\ldots,T\}\) 时
\[\sum_{t=2}^T\ell_t=(T-1)\mathbb E_t[\ell_t].\]于是一个随机时间步就能形成无偏的和式估计,乘上 \(T-1\) 即可。若只关心这个目标的最优点,统一乘在所有相关项上的正常数不改变最优点;如果要和 \(L_0\) 或其他目标组合,则要保持相对尺度一致。
更一般地,若按 \(r(t)>0\) 抽样,
\[\sum_t\ell_t=\mathbb E_{t\sim r}\left[\frac{\ell_t}{r(t)}\right].\]改采样分布而保留重要性修正,可以仍然估计原目标;改采样分布却不修正,通常就改变了不同时间步的有效权重。
11.5 常用的 简化损失 做了什么改变
原始 DDPM 使用的简化噪声预测目标是
\[\boxed{ L_{\mathrm{simple}} =\mathbb E_{\substack{x_0\sim p_{\mathrm{data}},\ t\sim\mathrm{Uniform}\{1,\ldots,T\}\\ \epsilon\sim\mathcal N(0,I)}} \left[\|\epsilon-\epsilon_\theta( \sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon,t)\|^2\right]. }\]它没有保留刚才的 \(w_t\),并且把噪声回归用到了包含 \(t=1\) 的训练日程。所以它与完整负 ELBO 有清楚的联系,但不与其逐项相等。原论文的样本质量实验支持这种训练选择;这是一项有实验依据的目标重加权,不能写成“因为权重是常数,所以都能删掉”。不同 \(t\) 的权重虽然不依赖模型参数,却决定共享网络在不同任务之间如何分配拟合能力。DDPM §3.4
一个细微补充是:在函数空间无限灵活、每个时间和输入都能达到理想条件最优的情形,正的仅依赖时间的权重不会改变每个时间的条件均值解。但实际网络在时间间共享参数,容量、优化与数据有限,权重会影响得到的解。两个目标不能因此被视作相同。
11.6 预测干净样本与预测噪声,为什么损失权重不同
给定一个噪声预测器,可以构造干净样本估计
\[\widehat x_{0,\theta}(x_t,t) =\frac{x_t-\sqrt{1-\bar\alpha_t}\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}}.\]用这个估计减去真实 \(x_0\) 的表达式:
\[\widehat x_{0,\theta}-x_0 =-\sqrt{\frac{1-\bar\alpha_t}{\bar\alpha_t}} \left(\epsilon_\theta-\epsilon\right).\]于是,在 \(0<\bar\alpha_t<1\) 时
\[\boxed{ \|\epsilon_\theta-\epsilon\|^2 =\frac{\bar\alpha_t}{1-\bar\alpha_t} \|\widehat x_{0,\theta}-x_0\|^2 =\mathrm{SNR}(t)\|\widehat x_{0,\theta}-x_0\|^2. }\]对可以互相转换的预测结果,噪声空间中的等权 MSE,对应干净样本空间中的 SNR 加权 MSE。换一种网络输出、再沿用一个形式看似相同的“无权重 MSE”,不一定保留同一个训练目标。极高噪声时,直接反推 \(x_0\) 还包含除以很小的 \(\sqrt{\bar\alpha_t}\),误差尺度会被放大。
这条代数关系有助于阅读后来的参数化设计,但它不意味着所有参数化在有限网络中都能达到相同优化效果。
11.7 用前面的数值例子核对两个损失
继续使用第 9 节的一维例子:\(\beta_2=0.2,\alpha_2=0.8,\bar\alpha_2=0.72\),真实总噪声为 \(\epsilon=0.5\)。选择反向方差 \(\sigma_2^2=\widetilde\beta_2=1/14\),假设网络预测 \(\epsilon_\theta=0.3\)。
噪声误差平方为 \(0.2^2=0.04\)。相应权重为
\[w_2=\frac{0.2^2}{2\times(1/14)\times0.8\times0.28}=1.25.\]加权噪声损失因此是 \(1.25\times0.04=0.05\)。另一方面,两个反向均值的差的绝对值为
\[|\widetilde\mu_2-\mu_\theta| =\frac{0.2}{\sqrt{0.8}\sqrt{0.28}}\times0.2 \approx0.084515.\]由于两个高斯方差相同,KL 的方差常数项为零,所以
\[D_{\mathrm{KL}}(q\Vert p_\theta) =\frac{0.084515^2}{2\times(1/14)}\approx0.05.\]两条计算路径一致。这个检查不仅验证公式,还说明权重不是装饰:若直接报告无权重 MSE,数值就是 \(0.04\),不再是这里的高斯 KL。
12. 网络预测的“噪声”到底是什么,以及怎样生成图像
12.1 MSE 的最优预测是条件期望
训练时我们知道加入的 \(\epsilon\),但网络只看到 \(x_t,t\)。不同的 \((x_0,\epsilon)\) 可能产生相同或相近的 \(x_t\),所以网络一般不可能从一次输入中唯一还原“当时实际抽到的那份噪声”。
对于固定时间 \(t\) 和输入 \(x_t\),记 \(m=\mathbb E[\epsilon\mid x_t,t]\)。平方误差分解为
\[\mathbb E[\|\epsilon-f(x_t,t)\|^2\mid x_t,t] =\mathbb E[\|\epsilon-m\|^2\mid x_t,t] +\|m-f(x_t,t)\|^2.\]交叉项为零,因为 \(\mathbb E[\epsilon-m\mid x_t,t]=0\)。第一项不受 \(f\) 影响,因此理论最优预测为
\[\boxed{\epsilon^*(x_t,t)=\mathbb E[\epsilon\mid x_t,t].}\]训练标签是一份具体噪声,理想回归函数是条件平均,这两件事并不矛盾。和普通监督回归一样,单样本标签可以含有给定输入之后仍然存在的不确定性。
12.2 与 score 的联系也能直接推出
令带噪数据的边缘密度为
\[q_t(x_t)=\int p_{\mathrm{data}}(x_0)q(x_t\mid x_0)\,dx_0.\]在可交换求导与积分的条件下,
\[\begin{aligned} \nabla_{x_t}\log q_t(x_t) &=\frac{\int p_{\mathrm{data}}(x_0) q(x_t\mid x_0)\nabla_{x_t}\log q(x_t\mid x_0)\,dx_0}{q_t(x_t)}\\ &=\mathbb E_{x_0\sim q(x_0\mid x_t)} [\nabla_{x_t}\log q(x_t\mid x_0)]. \end{aligned}\]条件高斯的对数密度梯度为
\[\nabla_{x_t}\log q(x_t\mid x_0) =-\frac{x_t-\sqrt{\bar\alpha_t}x_0}{1-\bar\alpha_t} =-\frac{\epsilon}{\sqrt{1-\bar\alpha_t}}.\]于是
\[\boxed{ \nabla_{x_t}\log q_t(x_t) =-\frac{\mathbb E[\epsilon\mid x_t,t]}{\sqrt{1-\bar\alpha_t}}. }\]这个状态空间中的梯度称为 score。理想噪声预测器经过已知尺度换算,就提供了带噪边缘分布的 score。实际网络只是近似它;也不要把条件分布的 score 与边缘分布的 score 直接混写,中间正是那个条件期望。
12.3 一步反向采样
按高斯反向模型,在中间步采样:
\[\boxed{ x_{t-1} =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\right) +\sigma_t\eta_t, \quad\eta_t\sim\mathcal N(0,I). }\]这里的 \(\eta_t\) 是反向采样中新抽取的噪声,与训练时构造 \(x_t\) 使用的 \(\epsilon\) 不同。保留随机性,是在从条件分布采样,而不是每一步只取一个均值。
原论文展示的采样算法在最后 \(t=1\) 时把随机项设为零,返回预测均值。这是其实际采样约定。严格按离散观测模型 \(p_\theta(x_0\mid x_1)\) 抽样,则应按量化区间的概率采样;不要把“最后一步不加噪声”误读成完整概率模型的观测方差必然为零。
12.4 完整训练与采样清单
训练一次 minibatch:
- 取真实数据 \(x_0\),均匀抽时间 \(t\),抽标准高斯噪声 \(\epsilon\)。
- 直接构造 \(x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon\)。
- 网络接收 \(x_t,t\),输出 \(\epsilon_\theta(x_t,t)\)。
- 计算简化 MSE,或明确选择的加权变分目标。
- 更新网络参数;固定前向日程不参与梯度更新。
原始逐步反向生成:
- 抽取 \(x_T\sim\mathcal N(0,I)\)。
- 从 \(t=T\) 递减到 \(1\),计算噪声预测与反向均值。
- 对 \(t>1\) 按所选方差加入新噪声;按最后一步的既定约定输出 \(x_0\)。
训练通常只采样一个时间步,所以一次梯度更新不需要经过整条反向链。原始采样却需要反复调用网络。这种训练与生成计算结构的不对称,是理解扩散模型效率问题的起点;后来的加速采样器和其他生成路径,需要各自单独的推导,不能直接当作同一个算法少执行几步。
13. 把 VAE 与 DDPM 放回同一张地图
到这里,可以把两篇论文放在一个共同的潜变量框架中比较。
| 问题 | 本文讨论的 VAE | 原始 DDPM |
|---|---|---|
| 观测 | \(x\) | \(x_0\) |
| 潜变量 | 一个或一组 \(z\),常用低维连续表示 | 整条 \(x_{1:T}\),各状态与数据同维 |
| 生成方向 | \(z\to x\) | \(x_T\to\cdots\to x_0\) |
| 推断分布 | 学习 \(q_\phi(z\mid x)\) | 固定 \(q(x_{1:T}\mid x_0)\) |
| 训练网络 | 编码器与解码器 | 带时间条件的反向网络 |
| 共同理论工具 | 边缘似然的变分下界 | 边缘似然的变分下界 |
| 常用训练实现 | 采样重构项+解析 KL | 随机时间的噪声预测 MSE |
| 主要随机性 | 潜变量采样,及可能的观测采样 | 终点噪声与逐步反向采样 |
DDPM 可以看作具有固定推断链和特殊参数化的层次潜变量模型。这个视角解释了它为什么同样有 ELBO,也解释了“VAE 和扩散模型完全没有数学关系”的说法为什么不准确。
但相同的概率框架不意味着它们拥有相同的计算结构。标准 VAE 常把数据压到较低维的潜表示,DDPM 的像素空间噪声链没有自动提供这样的压缩。VAE 的重参数化用于对含随机潜变量的期望求梯度;DDPM 的噪声参数化用于表达反向均值并构造监督回归目标。两者都出现 \(\mu+\sigma\epsilon\),具体解决的问题却不同。
13.1 为什么不能用“VAE 模糊,扩散清晰”结束比较
固定方差高斯观测模型下,平方误差倾向于条件均值。面对多种可能的输出,均值可能平滑掉细节。但这是概率模型、条件信息和训练目标共同作用的结果,不能推出“所有 VAE 必然模糊”。
同样,扩散模型的多步生成能逐步表达复杂分布,但清晰度、条件一致性与事实正确性仍取决于数据、表示、模型容量和优化。用一个视觉印象替代建模假设,会让后面讨论现代潜空间模型时处处碰壁。
13.2 编码 KL 与信息量之间还有一条有用的恒等式
定义编码器在整个数据分布上的聚合后验:
\[q_\phi(z)=\int p_{\mathrm{data}}(x)q_\phi(z\mid x)\,dx.\]在联合分布 \(q_\phi(x,z)=p_{\mathrm{data}}(x)q_\phi(z\mid x)\) 下,对每条数据的先验 KL 取平均:
\[\mathbb E_{x\sim p_{\mathrm{data}}}D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)) =\mathbb E_{q_\phi(x,z)}\log\frac{q_\phi(z\mid x)}{p(z)}.\]在对数内部乘除 \(q_\phi(z)\):
\[\begin{aligned} \mathbb E_{x\sim p_{\mathrm{data}}}D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)) =&\mathbb E_{q_\phi(x,z)}\log\frac{q_\phi(z\mid x)}{q_\phi(z)}\\ &+\mathbb E_{q_\phi(x,z)}\log\frac{q_\phi(z)}{p(z)}. \end{aligned}\]第一项是互信息 \(I_q(X;Z)\);第二项的被积函数不依赖 \(x\),把 \(x\) 边缘化后得到
\[\boxed{ \mathbb E_{x\sim p_{\mathrm{data}}}D_{\mathrm{KL}}(q_\phi(z\mid x)\Vert p(z)) =I_q(X;Z)+D_{\mathrm{KL}}(q_\phi(z)\Vert p(z)). }\]这个分解说明,编码 KL 同时涉及“表示携带多少关于输入的信息”和“整个潜分布与先验是否匹配”。因此 KL 数值不能直接当作互信息;二者还差一个非负项。率失真视角可以进一步帮助分析这种权衡。Fixing a Broken ELBO
如果对几乎所有数据都有 \(q_\phi(z\mid x)=p(z)\),那么 \(z\) 不再携带关于 \(x\) 的信息。所谓后验坍塌可以用这个极端情形理解,但是否发生、程度如何,需要看模型与训练,不能只凭损失中存在 KL 就下结论。
14. 从原始论文到潜空间图像与视频生成
14.1 为什么先压缩,再扩散
现代潜空间生成常把整个系统分成两层:
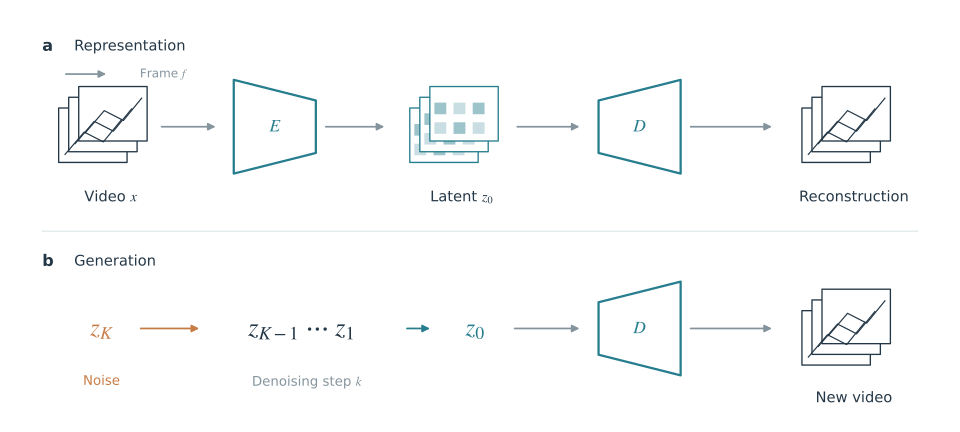
\[x\xrightarrow{\text{编码器 }E}z_0, \qquad z_T\xrightarrow{\text{潜空间生成模型}}z_0 \xrightarrow{\text{解码器 }D}\widehat x.\]这里 \(z_0\) 是压缩后的干净潜表示;若在潜空间做扩散,\(z_t\) 才表示带噪潜状态。这个 \(z_0\) 与前面 VAE 的 \(z\) 有联系,但不能和像素 DDPM 的 \(x_t\) 不加解释地换用。
较小的潜张量可以减轻后续生成模型的计算压力。代价是编码和解码成为系统的一部分:表示保留哪些信息、引入什么失真,会影响后续模型可以利用的内容。
LDM 原论文的第一阶段自编码器使用感知损失和局部对抗损失,并讨论轻量 KL 正则与 VQ 正则两种方案。因此,现代论文说“使用 VAE”时,未必意味着只优化 2013 年那份原始 ELBO。其表示、损失组合与使用目的,需要逐项核对。LDM §3.1–3.2
14.2 既然有高斯正则,为什么还需要学习潜空间分布
轻量 KL 正则不保证每个条件后验都等于标准高斯,也不保证聚合后验 \(q_\phi(z)\) 恰好等于标准高斯。数据编码形成的潜空间分布依然具有丰富结构。
潜空间扩散的任务,是从噪声端的简单分布生成这种数据端的复杂潜分布。需要分清三个对象:
- 用于正则编码器的先验 \(p(z)\);
- 扩散链最末端用于启动生成的噪声分布;
- 扩散模型最终要生成的干净数据潜分布。
它们可能都出现高斯符号,却处在不同的建模层次。把它们合并成“潜变量都是标准正态”,就无法解释潜空间生成模型究竟在学什么。
14.3 视频有两种时间,必须分开记
对视频,使用 \(f\) 表示视频帧或潜时间位置,用 \(k\) 表示去噪时间步。一个 \(z_k\) 可以是一整段视频的带噪潜张量,而 \(z_k[f]\) 才是其中某个时序位置。
一次 \(k\to k-1\) 更新,通常是在更新整段带噪视频表示,不等于生成下一帧。增加去噪步数也不自动保证跨帧身份、物理关系或动作顺序保持一致;这些还要求表示与网络能处理时序信息。
以 CogVideoX 为具体例子,其 3D causal VAE 同时压缩空间和时间,训练组合 L1、LPIPS、KL,并引入 3D 判别器相关的对抗损失。这些属于后来的视频系统设计,而不是 VAE 原论文已经给出的全部配方。CogVideoX §2.1
查看原图 · 手机上可横向滑动查看完整图示。
图 4:压缩模块决定表示方式,生成模块学习该空间中的分布。视频帧轴与去噪步轴是不同的轴;图中只表示结构关系,不表示某个具体模型的张量尺寸。
14.4 压缩之后,合理补全与忠实恢复需要分别评价
设两个输入经过编码后变得无法区分,且解码器没有其他区分信息。那么相同潜表示无法唯一确定它最初来自哪一个输入。生成器可以给出合理候选,却不能保证找回那一次真实输入中特有的细节。
这个论点依赖“信息确实无法区分”和“没有额外旁路”两个前提。不能仅凭潜变量维度较小,就对所有数据宣称某类细节必然丢失;如果还存在文本、参考图或其他条件 \(c\),应该讨论 \((z,c)\) 联合保留了什么信息。
也不能把自编码重建 PSNR 当作所有生成指标的严格上限。重建与生成考察的分布、目标和输入条件可能不同。更实用的做法是先检查 encode–decode 能否保留任务关心的事实,再检查潜分布学习与采样效果,逐层定位问题。
15. 面向高效多模态推理与生成后训练,可以继续追问什么
以下内容是从前述公式延伸出的研究问题与分析框架,不是两篇原始论文已经证明的结论,也不代表已经完成了相关实验。
15.1 压缩预算相同,保住的证据是否相同
高效多模态推理和潜空间生成都关心有限预算下的信息处理,但它们压缩的对象未必相同。
- 图像或视频自编码器改变表示空间。
- 条件视觉 token 剪枝或 KV 淘汰,改变后续计算可直接访问的条件证据。
- 对去噪状态 token 的处理,改变的是生成状态的计算。
- 稀疏注意力改变信息传递路径,不一定删除 token;删除 token 后,信息也可能已经写入其他状态。
例如 FastV 研究了在视觉语言模型内部利用注意力信息减少视觉 token 的计算。这可以提供效率问题的具体参照,但不应直接称作“另一种 VAE”。FastV 原论文
一个值得验证的问题是:对画面整体观感不显著的细节,是否恰好决定推理答案?小字、数量、短暂动作、物体身份,都可能占很少的像素,却承载关键证据。于是除了平均重建指标,还应分别评价文字、计数、身份与动作顺序等任务。
若同时研究时空压缩与条件剪枝,可以做“压缩强度 × 条件保留预算”的交叉消融。先单独改变一个因素,再看交互作用;同时检查是否存在信息旁路。只看一个端到端分数,往往无法判断错误到底发生在表示、证据访问还是后续推理。
15.2 从去噪链到强化学习:可算的是每步概率
下面讨论的随机策略,要求每个计入求和的转移都有可微、非退化的概率密度或离散概率质量,且支持集不随参数移动。若生成还受条件 \(c\) 控制,例如文本提示,随机反向链为
\[p_\theta(x_{0:T}\mid c) =p(x_T)\prod_{t=1}^Tp_\theta(x_{t-1}\mid x_t,c).\]希望提高终点奖励 \(R(x_0,c)\) 时,可以定义
\[J(\theta) =\mathbb E_{c,\,x_{0:T}\sim p_\theta(\cdot\mid c)}[R(x_0,c)].\]当条件 \(c\) 的采样分布与初始噪声分布固定、奖励对 \(\theta\) 无显式依赖,且相关可微与可积条件成立时,用对数导数恒等式得到
\[\begin{aligned} \nabla_\theta J &=\mathbb E\left[R(x_0,c)\nabla_\theta\log p_\theta(x_{0:T}\mid c)\right]\\ &=\boxed{\mathbb E\left[ R(x_0,c)\sum_{t=1}^T \nabla_\theta\log p_\theta(x_{t-1}\mid x_t,c) \right]}. \end{aligned}\]第一步是 score-function 恒等式;第二步利用轨迹概率的乘积分解,以及 \(p(x_T)\) 不依赖 \(\theta\)。它提供了把每次去噪视作一个决策步骤的入口。实际算法还要处理方差、优势估计、更新幅度等问题。DDPO 沿着这种多步决策视角优化扩散生成奖励。Training Diffusion Models with Reinforcement Learning
如果实际采样含有参数相关的确定性末步,就不能给该步套上非退化高斯的 log-probability,也不能不加说明地把它从梯度中略去;必须按真实采样策略和奖励依赖关系重新推导。前文 DDPM 的无噪声末步约定,与这里假定的逐步随机策略需要分别处理。
这里“单步高斯转移的 log-probability 可计算”,不代表“最终图像的边缘似然可直接计算”。后者仍然需要把整条隐含轨迹积分掉。VAE 开头遇到的边缘化困难,在这一层又出现了。
15.3 两种 score,以及为什么不能直接套到确定性 flow
第 12 节的 score 是
\[\nabla_{x_t}\log q_t(x_t),\]对状态求导,描述当前密度如何随位置变化。强化学习梯度里的 score-function 是
\[\nabla_\theta\log p_\theta(x_{t-1}\mid x_t,c),\]对模型参数求导,用于改变产生某条轨迹的概率。两个式子都出现“对数概率的梯度”,求导对象与使用目的不同。
还需要区分 DDPM 和 flow matching。Flow Matching 的基本训练形式,是在选定概率路径上回归速度场;生成时可以求解相应 ODE。它与扩散路径存在联系,但不能把它的速度目标普遍写成 DDPM 的噪声 MSE。Flow Matching for Generative Modeling
如果实际使用确定性 ODE 采样,一步更新是确定映射,条件转移是退化分布,不能不加说明地套一个具有正方差的高斯 log-probability。若要使用随机策略梯度,应先明确实际随机策略、噪声尺度和动作概率;若采用其他梯度方法,也需要其自身的推导。
15.4 奖励上升以后,究竟改善了什么
若奖励主要看少数抽帧的美观,可能遗漏动作顺序、跨帧身份或条件事实。这是一项需要检验的风险,不是对所有奖励模型的断言。
一个有解释力的诊断顺序是:
- 表示检查: 原视频经过编码与解码后,关键证据还在不在?
- 分布检查: 固定压缩器,生成模型是否学到了所需的时空变化?
- 采样检查: 固定模型,采样路径与计算预算怎样影响效果?
- 奖励检查: 固定压缩器、采样与评测设置,对比后训练前后,条件满足、时间一致性、多样性与分布外表现是否同时改善?
如果只报告最后一个奖励数值,就很难区分真实能力改善、表示瓶颈、采样变化和对奖励的投机利用。将各层分开,是把数学结构转化成可检验实验问题的一种方式。
16. 一个小型自测:能否把公式重新拼回去
读完后,可以不看正文回答下面六个问题。它们比记住网络名称更能检验是否理解了这条主线。
- ELBO 中的 KL,与 ELBO 和似然之间的差,是同一个 KL 吗? 不是。前者比较近似后验与先验;后者比较近似后验与真实后验。
- VAE 编码器输出 \(s=\log\sigma^2\),采样时乘在噪声前面的是多少? 是 \(\exp(s/2)\)。
- 只拿到一个 \(x_t\),训练最优的噪声预测器能否唯一还原某次真实噪声? 一般不能;平方误差的理想解是条件期望。
- \(q(x_{t-1}\mid x_t,x_0)\) 是高斯,是否能据此宣布 \(q(x_{t-1}\mid x_t)\) 必然也是高斯? 不能;去掉条件 \(x_0\) 后需要对可能的干净数据进行混合。
- 固定时间权重不依赖参数,为什么不能随便删? 因为不同时间的相对权重会影响共享网络优化的整体目标。
- 逐步去噪生成视频,是否等于每个去噪步骤生成下一帧? 不是;去噪时间与视频时间是两个不同的索引。
17. 收束:把损失、分布和算法连起来
VAE 让我们看清了一个核心结构:真实后验难算,就引入可计算的近似后验;边缘似然难算,就优化一个与它有精确关系的下界;采样妨碍普通计算图直接求导,就寻找参数无关噪声的可微变换。
DDPM 进一步利用了一条设计好的高斯链:前向边缘分布可解析采样,给定干净数据的单步后验可解析计算,变分目标可以按时间拆成高斯 KL,均值回归又可以重参数化成噪声回归。最终那一行简洁的 MSE,背后是这整套概率结构。
把两篇论文读到这一层,后续再看潜空间视频模型、采样加速或生成后训练时,就有了一组稳定的检查问题:表示是什么?随机过程是什么?概率对谁定义?梯度对谁计算?工程目标改掉了哪一部分理论目标?评价指标又真正衡量了什么?
这些问题比“模型属于哪一个名字”更能帮助定位一个方法的贡献和边界。
参考文献与继续阅读
以下链接为原始论文或作者公开的论文版本。基础推导主要对应前两篇;现代系统与研究问题另列,避免把后续设计归入原论文。
- Diederik P. Kingma, Max Welling. Auto-Encoding Variational Bayes. 2013. arXiv:1312.6114,正文。重点:§2–3 的 ELBO、估计器与重参数化,附录 B 的高斯 KL 与附录 C 的概率网络参数化。
- Jonathan Ho, Ajay Jain, Pieter Abbeel. Denoising Diffusion Probabilistic Models. 2020. arXiv:2006.11239,正文。重点:§2–3 的过程与目标,附录 A 的变分分解。
- Robin Rombach et al. High-Resolution Image Synthesis with Latent Diffusion Models. 2021/2022. 论文。重点:§3.1–3.2 的感知压缩与潜空间扩散。
- Zhuoyi Yang et al. CogVideoX: Text-to-Video Diffusion Models with An Expert Transformer. 2024. 论文。重点:§2.1 的时空自编码器。
- Alexander A. Alemi et al. Fixing a Broken ELBO. 2017/2018. 论文。重点:率失真与表示信息量。
- Kevin Black et al. Training Diffusion Models with Reinforcement Learning. 2023/2024. 论文。重点:将随机去噪过程建模为多步决策。
- Yaron Lipman et al. Flow Matching for Generative Modeling. 2022/2023. 论文。重点:概率路径与速度场回归。
- Liang Chen et al. An Image is Worth 1/2 Tokens After Layer 2: Plug-and-Play Inference Acceleration for Large Vision-Language Models. 2024. 论文。用于讨论视觉 token 计算预算,与自编码压缩作概念区分。