Flash-GRPO 学习笔记:理解视频扩散的单步策略优化
从完整 rollout 与单步策略更新出发,理解 ITG 的组内条件化、TGR 的梯度尺度修正,以及论文实验的结论与边界。
视频生成模型已经能根据文字生成一段画面,但“能生成”和“生成得让人满意”之间,还有不少距离。画面是否好看、主体有没有变形、动作是否符合提示词,这些目标很难只靠预训练的去噪损失表达。一个自然的办法是:让模型先生成视频,再用奖励模型评分,最后通过强化学习提高高分结果出现的概率。
问题也很直接:视频本来就生成得慢,如果每一轮强化学习还要处理许多去噪时间点的策略更新,训练成本会很高。
Flash-GRPO 关心的正是这个问题。它保留完整的视频生成过程,却只在其中一个去噪时间点计算策略优化项;随后用两个设计,让这个稀疏的训练信号更可靠:ITG 让组内样本在相同时间条件下比较,TGR 修正策略梯度里显式的时间尺度。
这篇笔记按“先看算法在做什么,再推导为什么这样做”的顺序展开。重点是把 one-step、group 和 gradient rectification 三个词接起来,理解它们分别解决了什么问题。
本文依据 He 等人的 ICML 2026 论文正式记录与 arXiv v3 全文整理。文中的实验数字均来自作者报告;数值小例子、成本模型和三张流程图是为解释机制而制作的示意,不是复现实验。
1. 先弄清楚 one-step 指哪一步
先把视频生成想成一条从噪声到视频的路线:
\[x_T \longrightarrow x_{T-1} \longrightarrow \cdots \longrightarrow x_0.\]这里每一个 \(x_t\) 都是整段视频的 latent 状态,同时包含空间与时间信息。沿着箭头走,表示视频逐渐去噪;不是从视频第一帧走到最后一帧。后面出现的 temporal,指的也是扩散时间。
通常我们会从多个去噪时间点构造策略损失。Flash-GRPO 则先选一个位置:这一处使用带随机性的 SDE 转移,其余位置使用 ODE;视频照常生成到终点,得到奖励后,只对选中的转移计算策略优化项。
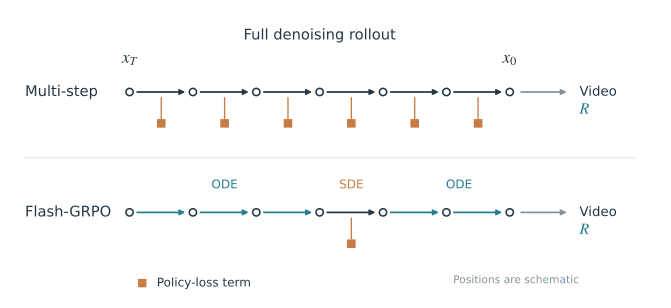
图 1:两种方案都走完整条生成轨迹。图中更新标记只表示哪些位置贡献策略训练项,不表示实际耗时比例。原创示意图。
因此,理解标题时最好把四件事分开:
- 生成多少步:仍然需要完整 rollout,才能得到可评分的视频。
- 哪些步引入随机转移:每条轨迹只有选中位置使用 SDE。
- 哪些步参与策略优化:只对选中位置计算策略比率与梯度。
- 训练多少轮:依然反复采样、评分和更新。
论文训练 Wan2.1-1.3B 时采用 20 步 rollout,训练 14B 时采用 12 步;评估仍用 50 步。所谓 one-step 描述的是策略优化使用的时间点数,不能据此推断模型已经变成一步视频生成器。来源:论文 §4.1、§5.1、附录 C
2. 暂时不看公式,完整算法是什么样的
设想一个 prompt:“一只小狗沿着海边奔跑。”这一轮训练不只生成一个视频,而是生成 \(G\) 个候选视频,组成一个组。
Flash-GRPO 的一轮训练可以先记成下面这条链:
- 给这个 prompt 选一个合法的去噪位置 \(t_k\)。
- 从不同初始噪声出发,生成 \(G\) 条轨迹。它们都在 \(t_k\) 使用 SDE,其余位置使用 ODE。
- 把每条轨迹走完,解码视频并计算奖励。
- 在同一 prompt、同一选择时间的组内比较奖励,得到相对优势。
- 回到保存下来的选中转移,计算当前策略与采样策略的概率比。
- 对策略项加上时间修正权重,更新模型参数。
如果一个 batch 里有多个 prompt,各组可以选不同的 \(t_k\)。这样,每条轨迹只训练一个位置,整个 batch 仍能覆盖不同去噪阶段。
还要记住,去噪网络在不同时间共享参数。只在一个位置计算梯度,并不意味着参数更新之后,只有这个位置的行为会变化;其他时间的网络输出也可能受到影响。这里稀疏的是构造训练信号的位置,模型本身仍然要承担整条生成过程。
这里有两个马上会冒出来的问题:
为什么同组视频必须选择相同时间?为什么选中一步之后,还要再给梯度乘一个系数?
前一个问题通向 ITG,后一个问题通向 TGR。要回答它们,我们先补上 GRPO 与随机转移这两块背景。
3. 从生成视频到 GRPO
3.1 什么是状态、动作和奖励
在这个问题中,可以把一次去噪转移看成策略的一次决策。
| 符号 | 含义 |
|---|---|
| \(c\) | 文本条件,即 prompt |
| \(x_t\) | 当前去噪位置的整段视频 latent |
| \(y_t\) | 从 \(x_t\) 出发,一次转移后得到的下一状态 |
| \(v_\theta(x_t,t,c)\) | 模型预测的向量场,参数为 \(\theta\) |
| \(\pi_\theta(y_t\mid x_t,c)\) | 下一状态的条件概率密度,即策略 |
| \(R(x_0,c)\) | 完整视频的终局奖励 |
| \(G\) | 同一个 prompt 的候选轨迹数 |
为了避免离散下标与连续时间混淆,本文用 \(y_t\) 表示原论文写作 \(x_{t-1}\) 的“下一状态”。在后面的 SDE 公式里,\(t\) 是归一化扩散时间,\(1-t\) 也是这个连续时间变量的函数。
奖励通常要等视频生成完才能计算。例如,奖励模型可能更偏好构图自然、主体清晰的结果。我们得到的是最终视频好不好,却希望据此调整某一步转移出现的概率。这就是终局奖励与中间策略之间的联系。
这里采用的是 likelihood-ratio,也叫 score-function 策略梯度思路。奖励可以只是一个黑盒给出的标量,不要求把奖励模型的导数沿整条生成链反向传播。因此,“全轨迹策略优化”主要指多个时间点都构造训练项,不能直接理解为必须保留贯穿全部采样步骤的一张巨大可微计算图。
3.2 相对优势在比较什么
对于同一 prompt \(c_k\),记第 \(i\) 个视频的奖励为 \(R_{k,i}\)。一个便于理解的组内标准化写法是:
\[\mu_k=\frac{1}{G}\sum_{i=1}^{G}R_{k,i}, \qquad s_k=\operatorname{Std}_{i}(R_{k,i}),\] \[\hat A_{k,i}=\frac{R_{k,i}-\mu_k}{s_k+\epsilon_A}.\]\(\hat A_{k,i}\) 就是相对优势。奖励高于组平均,它为正;低于组平均,它为负。分母把不同组的数值尺度拉近,\(\epsilon_A\) 是避免除零的小量。如果一组视频的奖励完全一样,去中心化后的信号也会消失。
这是一种教学展开:论文附录要求计算组内奖励的 mean/std,但正文没有把上面完整式子作为单独编号公式给出;实际代码的统计方式还有配置选项。
直觉上,这就像同一道题让模型交出几份答案,再比较“这一组里哪些更好”。它不需要先规定一个放之四海而皆准的及格线,但比较是否合理,取决于组里究竟放了哪些样本。
3.3 为什么还需要概率比和 clipping
视频是用采样时的旧策略 \(\theta_{\mathrm{old}}\) 生成的,更新时我们调整的是当前参数 \(\theta\)。把已采样的状态与动作固定下来,定义:
\[r_t^i(\theta) = \frac{\pi_\theta(y_t^i\mid x_t^i,c)} {\pi_{\theta_{\mathrm{old}}}(y_t^i\mid x_t^i,c)}.\]如果 \(r_t^i>1\),表示当前策略比旧策略更倾向于这次转移。对于正优势样本,我们希望这种转移更容易发生;对于负优势样本,则希望降低它的相对概率。
不过,直接优化 \(r\hat A\) 容易走得太远。GRPO 使用裁剪 surrogate:
\[S(r,\hat A) = \min\left[ r\hat A, \operatorname{clip}(r,1-\epsilon_{\mathrm{clip}},1+\epsilon_{\mathrm{clip}})\hat A \right].\]它限制的是某些方向上的额外优化收益,并不保证实际概率比永远待在裁剪区间内。这里的 \(\epsilon_{\mathrm{clip}}\) 也不要和优势标准化里的 \(\epsilon_A\) 混淆。
把许多样本、许多时间点的 surrogate 平均,再减去参考策略的 KL 惩罚,就得到常见的 GRPO 目标结构。参考策略 \(\theta_{\mathrm{ref}}\) 负责约束模型偏离原模型的程度;旧策略 \(\theta_{\mathrm{old}}\) 则负责定义本轮采样分布。二者承担不同角色。
下文统一用“最大化目标 \(J\)”的约定。如果写成由优化器最小化的 policy loss,应取 \(L_{\mathrm{policy}}=-J\)。来源:论文 Eq. (1)–(2)
4. 为什么要在一个位置使用 SDE
先看最简单的 ODE 离散更新:
\[x_{t+\Delta t}=x_t+v_\theta(x_t,t,c)\Delta t.\]给定 \(x_t\)、\(t\) 和 \(c\),下一状态由这个式子确定。对于刚才采用的高斯 log-prob 与概率比计算,我们希望有一个显式的随机转移核。
注意,ODE 采样整体仍然可以有随机性,因为初始噪声是随机抽取的。这里讨论的是“给定当前状态之后,这一步转移是否随机”,不是说所有 ODE 生成结果都一样。
论文使用的 SDE 离散转移可以写成:
\[y_t=\mu_\theta(x_t,t,c)+\sigma_t\sqrt{\Delta t}\,\xi, \qquad \xi\sim\mathcal N(0,I),\]其中:
\[\mu_\theta = x_t+ \left[ v_\theta+ \frac{\sigma_t^2}{2t}\bigl(x_t+(1-t)v_\theta\bigr) \right]\Delta t.\]为简洁起见,第二行把 \(v_\theta(x_t,t,c)\) 缩写成了 \(v_\theta\)。于是转移分布是:
\[\pi_\theta(y_t\mid x_t,c) = \mathcal N\!\left(y_t;\mu_\theta,\sigma_t^2\Delta t\,I\right).\]这样我们就能计算已采样转移的 log-density,进一步构造概率比。值得留意的是,SDE 同时引入了随机噪声与漂移修正;后面 TGR 的两个系数来源,恰好对应这两部分。
这里沿用论文局部推导的符号约定,\(\Delta t\) 表示正的步长尺度。实际反向采样的时间方向、离散索引与边界处理仍须由 sampler 正确实现,不能把这个展示公式直接当作可运行更新器。来源:论文 Eq. (3)–(4)、Eq. (8)–(9)
作者利用的是具有相同边缘分布的 ODE/SDE 之间的关系。连续时间理论给出了构造依据,但有限步长、近似向量场与具体噪声调度仍会带来实现层面的差异,不能据此保证任意离散采样配置都完全等价。
5. ITG:先把组内比较的条件对齐
5.1 朴素单步方案漏掉了什么
现在可以尝试一个很直接的加速方案:每条轨迹独立抽一个时间点,只训练那个点。
假设同一个 prompt 有四条轨迹,抽中的时间分别是 \(t_1,t_2,t_3,t_4\)。每条轨迹都完成视频生成,然后我们把四个最终奖励放进同一组,计算优势。
看起来没有问题,但随机扰动插入得早或晚,可能影响最终奖励的分布。于是,同一组奖励里混入了两种差异:一条视频在当前条件下表现如何,以及它恰好处在哪一种时间条件下。
如果某个时间条件的平均奖励本来就较高,它生成的普通样本也容易得到正优势;另一个条件下表现不错的样本,反而可能因为总体均值较低被划成负优势。
5.2 一个假设数值例子
以下数字只用于说明机制,不是论文实验。
设同一 prompt 下有两种 SDE 插入条件:时间 \(a\) 的典型奖励约为 6,时间 \(b\) 的典型奖励约为 3。我们抽到:
| 采样条件 | 视频奖励 | 相对混合组均值 4.5 的差 |
|---|---|---|
| 时间 \(a\) | 5.8 | +1.3 |
| 时间 \(a\) | 6.2 | +1.7 |
| 时间 \(b\) | 2.8 | −1.7 |
| 时间 \(b\) | 3.2 | −1.3 |
按这个混合 baseline,两个 \(a\) 样本都被奖励,两个 \(b\) 样本都被惩罚。可是,5.8 低于 \(a\) 的通常水平,3.2 高于 \(b\) 的通常水平。混合比较掩盖了这层信息。
如果分别比较 \(a\) 组的 5.8/6.2 和 \(b\) 组的 2.8/3.2,两组去中心化后都是 \(-0.2,+0.2\)。此时优势更接近“在相同时间条件下,谁做得更好”。现实中并不需要预先知道真实条件均值;例子里的 6 和 3 只是把混杂来源显式展示出来。
5.3 ITG 怎么改
ITG 的全称是 Iso-Temporal Grouping,可以理解为“同时间步分组”。做法很简单:以 prompt group 为单位抽时间,而不是让每条轨迹各抽各的。
对第 \(k\) 个 prompt,先抽一个 \(t_k\);组内所有 \(G\) 条轨迹共享这个 SDE 位置,然后在组内计算奖励均值与优势。
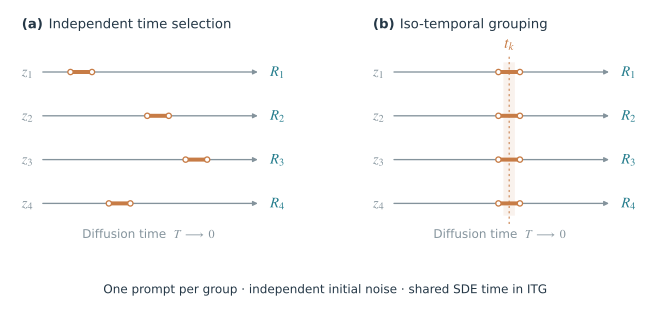
图 2:ITG 对齐的是随机转移插入的位置。组内轨迹仍从不同初始噪声出发;不同 prompt 组可以选择不同时间。原创示意图。
这里尤其要注意:同一个时间点,不等于同一个 latent。 各条轨迹使用不同初始噪声,所以走到 \(t_k\) 时,状态仍然不同。ITG 并没有让 \(G\) 个候选都从完全相同的中间状态分叉。来源:论文 §4.1、Eq. (5)–(6)
从统计角度,可以借助全方差公式理解它:
\[\operatorname{Var}(R\mid c) = \mathbb E_t\!\left[\operatorname{Var}(R\mid c,t)\right] + \operatorname{Var}_t\!\left(\mathbb E[R\mid c,t]\right).\]右侧第一项是固定时间条件下的奖励变化,第二项是不同时间条件均值之间的变化。固定 \(t\) 后再做组内比较,就不会把第二项对应的跨时间均值差混进同一个 baseline。
这是帮助理解的条件化解释,不是关于完整梯度估计器的普适方差定理。噪声、内容、网络响应和终局奖励的其他变化仍然存在。ITG 改善了比较条件,却没有测量出某一步对最终质量的纯粹因果贡献。
6. TGR:同样的优势,为什么会产生不同尺度的梯度
ITG 处理了“谁和谁比较”。接下来的问题是:即使比较条件合理,不同去噪时间上的策略梯度是否处在相近尺度?
TGR,即 Temporal Gradient Rectification,针对的是 SDE 参数化里一个可以解析写出的时间系数。我们从高斯转移逐步推导。
6.1 第一步:写出 log-density
将 \(x_t\)、采样得到的 \(y_t\)、\(t\) 与 \(\sigma_t\) 视为固定量,参数相关部分为:
\[\log\pi_\theta(y_t\mid x_t,c) = -\frac{\|y_t-\mu_\theta\|^2}{2\sigma_t^2\Delta t} +\text{constant}.\]constant 只是相对于 \(\theta\) 不变,它仍可能依赖时间。由于这里没有让模型同时学习转移方差,对参数求导得到:
\[\nabla_\theta\log\pi_\theta = \frac{(y_t-\mu_\theta)^\top}{\sigma_t^2\Delta t} \nabla_\theta\mu_\theta.\]分母说明,转移方差会影响 log-density 对均值变化有多敏感。同样大小的均值偏移,放在不同宽度的高斯分布里,意义并不一样。
6.2 第二步:均值如何依赖网络输出
把刚才的均值重新整理一下:
\[\mu_\theta = x_t+\Delta t\left[ \left(1+\frac{\sigma_t^2(1-t)}{2t}\right)v_\theta +\frac{\sigma_t^2}{2t}x_t \right].\]这里 \(x_t\) 固定,只有向量场 \(v_\theta\) 随模型参数变化,因此:
\[\nabla_\theta\mu_\theta = \Delta t\left(1+\frac{\sigma_t^2(1-t)}{2t}\right) \nabla_\theta v_\theta.\]除了直接的 \(v_\theta\),漂移修正项也依赖它。若漏掉后一部分,就得不到论文的完整时间系数。
6.3 第三步:合并得到 \(\lambda(t)\)
在采样策略处,有:
\[y_t-\mu_\theta=\sigma_t\sqrt{\Delta t}\,\xi.\]把残差与均值梯度代回去:
\[\begin{aligned} \nabla_\theta\log\pi_\theta &= \frac{\sigma_t\sqrt{\Delta t}\,\xi^\top} {\sigma_t^2\Delta t} \cdot\Delta t \left(1+\frac{\sigma_t^2(1-t)}{2t}\right) \nabla_\theta v_\theta\\[3pt] &= \underbrace{\left( \frac{\sqrt{\Delta t}}{\sigma_t} +\frac{\sigma_t\sqrt{\Delta t}(1-t)}{2t} \right)}_{\lambda(t)} \xi^\top\nabla_\theta v_\theta. \end{aligned}\]这就是 TGR 的关键观察:在噪声与网络 Jacobian 之外,还有一个由时间和 sampler 决定的显式标量 \(\lambda(t)\)。它来自“log-density 对均值的敏感程度”和“均值对网络输出的敏感程度”这两个环节。来源:论文 §4.2、Eq. (8)–(10)
为什么强调“在采样策略处”?因为如果用旧策略生成 \(y_t\),然后对当前策略做多次更新,那么 \((y_t-\mu_\theta)/(\sigma_t\sqrt{\Delta t})\) 已经不再是最初抽到的那个噪声值。依然可以把它定义为当前策略下的标准化残差,但不能继续假装它始终等于原来的高斯样本。
另一个容易混淆的地方是求导路径。这里固定已采样的状态和动作,计算 score-function 梯度;不能一边对 \(\mu_\theta\) 求导,一边沿采样过程让 \(y_t\) 同步变化,再据此说残差“不依赖参数”。那计算的是另一条导数路径。
6.4 第四步:用倒数权重修正
论文给出的未裁剪策略项可以用最大化目标写为:
\[J_{\mathrm{TGR}} = \frac{1}{G}\sum_i \frac{\hat A_t^i}{\lambda(t)}\,r_t^i(\theta).\]因为 \(\nabla_\theta r=r\nabla_\theta\log\pi_\theta\),在时间权重不参与求导时,乘上 \(1/\lambda(t)\) 就能抵消刚才那个显式系数。
将 clipping 一并写进去,一个便于理解的 Flash-GRPO 目标是:
\[J_{\mathrm{Flash}} = \frac{1}{BG}\sum_{k=1}^{B}\sum_{i=1}^{G} \frac{1}{\lambda(t_k)} S\!\left(r_{k,i},\hat A_{k,i}\right),\]其中 \(B\) 是 prompt 数。若实验使用 KL 项,再按相应设置加入。这是把论文的裁剪目标与时间权重合并后的说明性表达,不是原文某一个编号公式的直接抄写。来源:论文 Eq. (2)、Eq. (11)
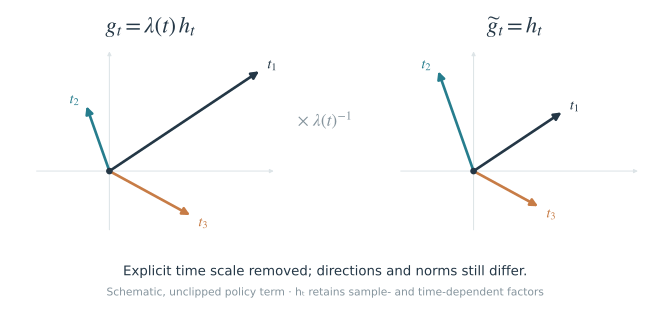
图 3:修正移除了可解析的 \(\lambda(t)\) 因子;优势、残差、概率比、网络 Jacobian 与 clipping 状态依然影响实际更新。原创示意图。
这里的结论要停在恰当的位置:TGR 消去显式标量因子,不保证所有时间点的最终梯度范数相等。它也不是通用的 gradient norm clipping。
此外,时间再加权改变了 surrogate 中各时间条件的权重。论文没有给出“它与未修正全轨迹目标始终完全相同且无偏”的一般证明。更换 SDE、噪声调度、离散方法或网络参数化之后,应该重新核对 \(\lambda(t)\);\(t=0\)、\(\sigma_t=0\) 等端点也必须由具体实现排除或处理。
公开实现还涉及固定 scheduler timestep 的权重表和 batch 归一化。从这条解析公式到适配任意 sampler,仍有工程工作要做。代码入口:官方单节点训练脚本
7. 把各部分重新拼成训练流程
现在回看算法,两个组件的分工就比较清楚了:ITG 决定组如何组织,TGR 决定选中策略项如何加权。
下面是说明性流程,不是可直接运行的代码,也没有逐字复刻论文伪代码:
重复进行 rollout 与参数更新:
    取一批 prompts,并固定本轮采样策略 θ_old
    对每个 prompt c_k:
        选择一个合法去噪位置 t_k
        从 G 份不同初始噪声开始完整生成
        在 t_k 使用 SDE,其余位置使用 ODE
        保存该位置的状态、下一状态与旧 log-prob
        解码最终视频,计算奖励
        在同 prompt、同 t_k 的组内计算相对优势
    对保存的选中转移计算当前 log-prob 与策略比率
    以 1 / λ(t_k) 加权裁剪 surrogate
    最小化其负值,并按实验设置处理 KL 等项
    在独立 prompts 上检查生成质量与训练稳定性
生成阶段不需要为了奖励保留整条反传图;更新阶段可以对选中转移重新计算所需的网络输出。具体如何同步旧策略、重复利用样本、做梯度累积与处理 log-prob,属于实际实现需要补齐的部分。来源:论文附录 C,Algorithm 1
8. 成本到底省在哪里
只训练一个时间点,整体耗时会不会直接降到原来的 \(1/T\)?先写一个粗略成本模型,就能看出答案取决于哪些计算占主要部分。
以下是原创的分析模型,不是论文实测。 对单个 prompt 组,一轮成本近似为:
\[C_{\mathrm{iter}} \approx G\left[ T C_{\mathrm{rollout}} +m\left(C_{\mathrm{update\_forward}}+C_{\mathrm{backward}}\right) +C_{\mathrm{reward}} \right] +C_{\mathrm{other}}.\]这里 \(T\) 是完整 rollout 步数,\(m\) 是每条轨迹用于策略优化的时间点数。\(C_{\mathrm{reward}}\) 可把视频解码与奖励评分一起计入;\(C_{\mathrm{other}}\) 则概括通信、调度与其他开销。
Flash-GRPO 将 \(m\) 降到 1,但 \(T\) 步生成和视频评分仍然存在。基线的 \(m\) 还取决于训练窗口,不一定等于 \(T\)。
举一个纯示意算例:忽略公共倍数 \(G\) 与其他开销,假设 \(T=20\),每步 rollout 成本为 1,每个训练时间点的更新成本为 3,解码与评分成本为 10。若基线训练 \(m=10\) 个时间点:
\[C_{\mathrm{base}}=20+10\times3+10=60,\] \[C_{\mathrm{single}}=20+1\times3+10=33.\]更新位置从 10 个减到 1 个,整体加速只有 \(60/33\approx1.82\) 倍。若更新本来占比更高,收益会更大;若奖励模型成为主要瓶颈,继续减少更新计算的收益就会受限。
同样的道理也适用于显存。稀疏更新可以减少多时间点策略训练需要的计算和中间信息,但模型参数、优化器状态以及其他固定开销并不会自然缩成 \(1/T\)。
论文图 1 报告约 6× 训练成本加速,图中训练代价使用 GPU Minutes,并同时展示 HPSv3 质量指标。这个结果应理解为作者设定下的效率证据;正文没有提供足够完整的分项测量,让读者把它直接推广成任意硬件、任意配置下的端到端六倍加速。来源:论文图 1
9. 实验结果应该怎么读
9.1 先看设置,避免比较错对象
| 项目 | 作者报告的设置 |
|---|---|
| 基座模型 | Wan2.1 1.3B 与 14B |
| 训练 prompts | 沿用 DanceGRPO 的 prompt 数据集 |
| 独立评估 | 300 条 held-out prompts |
| 训练 rollout | 1.3B 为 20 步;14B 为 12 步 |
| 评估采样 | 50 步 |
| CFG | 4.5 |
| 策略裁剪参数 | 0.001 |
| 视觉奖励 | HPSv3,对采样帧评分,取最高 30% 的帧分数平均 |
| 运动评分 | VideoAlign motion score |
| 外部维度评估 | VBench 的 aesthetic、imaging、subject consistency、object class |
来源:论文 §5.1。VBench 使用 enhanced prompts 与 negative prompts,并遵循官方评估协议。这里的裁剪阈值是 0.001,不能直接套用常见 PPO 示例中的 0.2。
直接 RL 对照包括 Flow-GRPO 和 Flow-GRPO-Fast1。需要留意两个细节:论文虽然将 Flow-GRPO 归为 full-trajectory 方法,但实际视频实验只训练去噪时间点的前半段;Fast1 则是将 Fast 方法的窗口设为 1 的特定版本。读实验时要保留这些设置,避免把结果扩大成对某个方法所有配置的评价。
MixGRPO 在机制讨论中出现,但没有单独的同设置定量结果行。因此,这篇论文并没有提供一张可以直接宣称“全面击败 MixGRPO”的实验表。
9.2 固定预算下,有哪些提升
下表摘录论文表 1 中与 Wan2.1-1.3B 对齐直接相关的结果。三个 RL 方法均使用 350 GPU-hours:
| 方法 | GPU-hours | Aesthetic | Imaging | Subject consistency | Object class |
|---|---|---|---|---|---|
| Wan2.1-T2V-1.3B | — | 65.46 | 66.79* / 67.01 | 97.56 | 88.84* / 88.81 |
| Flow-GRPO-Fast1 | 350 | 65.92 | 65.96 | 98.46 | 88.15 |
| Flow-GRPO | 350 | 65.79 | 68.60 | 97.28 | 87.92 |
| Flash-GRPO | 350 | 66.43 | 68.28 | 98.70 | 90.00 |
来源:论文表 1。带星号的是论文作者复现的基础模型分数,斜杠后是官方分数;原表明确提示两者存在不一致,不能择优混用。本文保留原表数字口径。
相对 Flow-GRPO,Flash-GRPO 的绝对分数变化是:aesthetic +0.64,imaging −0.32,subject consistency +1.42,object class +2.08。
所以,合理的结论是固定预算下多项指标改善,同时 imaging 略低。若把它概括成“四项全面领先”,就会丢掉真实存在的取舍。
同样,固定 GPU-hours 回答的是“同样预算能得到什么”,不等于固定 rollout 数、固定更新次数,也不等于所有方法充分收敛之后的质量上限。对高成本视频训练而言,预算比较很有意义,只是要说清它回答了哪一个问题。
9.3 消融最能说明两个组件的分工
| 方法 | 作者标记的稳定性 | HPSv3 评估奖励 |
|---|---|---|
| Wan2.1-1.3B | — | 4.67 |
| Naive single-step | × | 4.64 |
| + ITG | × | 5.31 |
| + ITG + TGR | ✓ | 5.42 |
来源:论文表 2。稳定性符号沿用作者报告,不是独立复现结论。
这张表有一个很值得注意的地方:朴素单步方案没有自然获得“便宜而有效”的结果;加入 ITG 后分数明显改善,却仍被标记为不稳定;再加入 TGR,分数升至 5.42,同时稳定性改善。
若只看最后两行相差 0.11,就容易低估 TGR 的作用。优化过程能否持续保持有效,比某一个时刻的分数差更重要。附录中的曲线也显示,只有 ITG 的配置在训练后期出现了退化。
另一方面,这张表没有 TGR-only 行,也没有完整的不同加入顺序对照。因此不能单凭它断言“只加 TGR 就一定足够”,更不能把一次 0.11 的差异说成经过统计显著性验证。
9.4 曲线和附录补充了哪些信息
论文图 4–5 显示,Flash 的 held-out HPSv3 可到约 5.4,Fast1 约为 4.64,Flow-GRPO 曲线峰值约为 5.1。但作者也说明,与 Flow-GRPO 的比较受成本限制,只覆盖训练 schedule 的前半段。它支持观察区间内的效率判断,不能替代无限训练至收敛的比较。
附录 A 中,加入 KL 后,Fast1 不再出现同样的崩溃,held-out HPSv3 约为 4.9,而 Flash 约为 5.35。这说明 KL 有稳定基线的作用,只是在作者设置下没有完全补齐收益差距。由此推出“KL 没用”显然过头了。
运动实验中,Flash 与 Fast1 的末端 motion score 约为 −0.28 和 −0.34。这里分数越高越好,负值并不表示计算错误,也不适合改写成准确率或随意计算百分比提升。来源:论文 §5.5、图 4–6、附录 A–B
10. 读完之后,哪些理解值得留下
10.1 稀疏训练不仅是在决定“少算多少”
独立为每条轨迹抽时间,与为整个 prompt group 抽时间,计算量可以非常接近,得到的比较条件却不同。ITG 提示我们:设计一个随机估计过程时,抽样单位本身就是算法的一部分。
减少更新次数只是第一步。怎样组织样本,让保留下来的每一次更新携带更合适的信号,往往同样重要。
10.2 信用分配与梯度尺度需要分别看
终局奖励要如何指导中间一步,属于信用分配问题;一个策略项为什么被某个时间系数放大,属于尺度问题。ITG 和 TGR 分别触及这两层。
不过,ITG 之后的最终视频仍然受初始噪声与其他 ODE 转移影响。因此,更准确的理解是它改善了相对奖励的组织方式。把这一点说成“已经完全解决单步因果归因”,会超出方法实际做的事情。
10.3 解析出来的系数,是排查优化问题的重要线索
面对不稳定训练,很容易先想到降低学习率、加强 KL 或裁剪梯度。TGR 展示了另一条思路:先沿着 log-prob 的计算链检查,sampler 是否引入了能明确写出的尺度变化。
这种检查很有价值,但仍需要实验验证。优势分布、奖励质量、网络 Jacobian 与优化器也可能带来不稳定,不能把所有现象都归因于 \(\lambda(t)\)。
10.4 奖励提高之后,还应该问什么
HPSv3 在实验中采用最高 30% 帧分数的平均。这个聚合规则突出高分帧,也可能弱化低质量片段的影响。这是值得检查的风险,并不意味着论文已经发生或证明了 reward hacking。
若进一步研究,可以同时报告全帧均值、较差分位数、时序指标和独立人评。运动分数提高也不能单独证明物理规律更正确;几项 VBench 指标改善,还不足以覆盖多样性、复杂运动与长视频稳定性。
附录展示的 1.3B 与 14B 视频对照提供了直观例子,但定性展示不能代替完整样本统计或人类评审胜率。
10.5 下一步最值得补的证据
如果要继续检验方法,以下实验能直接回应本文推导中的问题:
- 做完整的 2×2 组件消融,补齐仅 TGR 的对照,并使用多个随机种子。
- 按去噪时间统计奖励均值、方差、优势分布以及加权前后的梯度范数,检查机制解释是否与观察一致。
- 同时做固定预算与固定样本量比较,并测试不同训练窗口。
- 分别计时 rollout、解码、奖励计算、更新与通信,观察瓶颈是否转移。
- 更换奖励聚合与 scheduler,重新核对时间权重,观察质量取舍和稳定性。
这些是从现有证据推导出的研究问题,不是已经执行的实验计划或结果。论文正文与附录尚未给出可覆盖全部复现细节的硬件、显存、分项耗时、超参数和多随机种子方差记录;公开代码是进一步核对的入口,不能替代实际运行与测量。
11. 最后把整条逻辑连起来
Flash-GRPO 从一个很实际的需求出发:视频强化学习太贵,希望减少每条生成轨迹参与策略更新的时间点。
但只删去训练项,并不会自动得到有效算法。朴素单步方案会让组内比较混合不同时间条件,策略梯度还受到 SDE 带来的显式时间尺度影响。ITG 先让同一 prompt 的候选共享选择时间;TGR 再从高斯转移推导出 \(\lambda(t)\),用它的倒数修正策略项。
这样再看 one-step,它表达的是一种训练计算的分配方式:完整生成负责提供最终奖励,选中的随机转移负责承载局部策略更新,分组与权重共同决定这个信号如何发挥作用。
这篇论文最值得保留的阅读启发,是把“减少计算”继续追问到“剩下的计算在估计什么”。理解了这个问题,ITG 与 TGR 就不再只是两个附加模块,而是从单步优化面临的具体困难中自然长出来的设计。
参考资料
- He, X. et al. Flash-GRPO: Efficient Alignment for Video Diffusion via One-Step Policy Optimization. ICML 2026, PMLR 306:41272–41289. 正式会议页面
- Flash-GRPO arXiv v3,2026-06-16。HTML 全文 · PDF。本文公式、实验表与附录讨论以该版本及正式会议版核对。
- Flash-GRPO 官方项目。项目页面 · 代码仓库。代码用于理解实现入口,本文没有报告运行结果。
本文为原创学习笔记。流程图、数值解释与成本示例由本文重新组织;论文实验结果均在相应位置标注来源。资料核对日期:2026-10-15。